Как в файн ридер редактировать текст пдф
Как сохранить текст в формат PDF:
- На главной панели инструментов в выпадающем списке выберите режим сохранения оформления документа.
- Воспользуйтесь пунктом меню Файл>Сохранить документ как>Документ PDF или кнопкой сохранения результатов на главной панели инструментов. Нажмите на стрелку возле кнопки сохранения результатов и выберите из списка формат сохранения. Если нужного формата в списке нет, выберите пункт Сохранить в другом формате…, и в открывшемся диалоге сохранения выберите требуемый формат.
Совет. В случае необходимости вы можете настроить дополнительные опции сохранения на закладке Сохранить > PDF диалога Опции (меню Сервис>Опции… ).
Данная закладка содержит следующие группы настроек:
Вы можете указать размер бумаги, который будет использован при сохранении результатов распознавания в формат PDF. Размер бумаги задается в выпадающем списке Размер бумаги по умолчанию .
Выбор режима сохранения зависит от того, как вы будете использовать созданный документ в дальнейшем:
- Только текст и картинки
В данном режиме сохраняются распознанный текст и иллюстрации. PDF-файл такого типа имеет относительно небольшой размер, и в нем возможен полнотекстовый поиск. Внешний вид документа может незначительно отличаться от оригинала. - Текст поверх изображения страницы
В данном режиме сохраняются фон и иллюстрации исходного документа, на них накладывается распознанный текст. Обычно размер такого PDF-файла больше, чем файла, получаемого при сохранении в режиме Только текст и картинки . В PDF-документе этого типа есть возможность полнотекстового поиска, однако внешний вид документа может незначительно отличаться от оригинала. - Текст под изображением страницы
В данном режиме сохраняется изображение страницы, распознанный текст помещается на невидимый слой под изображением. Таким образом, получается документ с возможностью поиска по тексту, при этом внешний вид PDF-документа практически неотличим от оригинала. - Только изображение
В данном режиме сохраняется изображение страницы. Внешний вид полученного PDF-документа будет не отличим от оригинала, однако в таком документе невозможен поиск по тексту.
- Сохранять цвет фона и букв
Указывает, что при сохранении текста в формат PDF будет сохранен цвет букв и фона. - Сохранять колонтитулы
Отметьте эту опцию, если вы хотите, чтобы текст колонтитулов был сохранен. Если данная опция отключена, текст колонтитулов сохраняться не будет. - Разрешить теги PDF (для Acrobat 5.0 или более поздней версии)
Указывает, что при сохранении распознанного текста в формате PDF будут автоматически сохранены теги PDF. Помимо текста и иллюстраций PDF-файлы могут содержать информацию о структуре документа: логических частях, иллюстрациях и таблицах. Эта информация хранится в виде тегов PDF. Теги PDF обеспечивают удобство просмотра документа на экранах различного размера, например, на экранах карманных компьютеров. Внимание! Если распознанный текст содержит иврит или идиш, создание PDF-документа с тегами невозможно. Данная функциональность не поддерживается. - Использовать смешанное растровое содержание (MRC)
Отметьте эту опцию, если вы хотите, чтобы при сильном сжатии документа сохранилось высокое качество текста и изображений. В результате размер конечного файла будет небольшим, а качество текста и иллюстраций будет высоким.
Если распознанный текст содержит большое количество иллюстраций, то размер конечного файла может быть очень большим. Качество картинок и размер полученного файла зависят от выбранного значения в выпадающем списке группы Качество картинок .
- Для того чтобы задать параметры сохранения картинок, выберите пункт Пользовательское . В открывшемся диалоговом окне Параметры сохранения картинок выберите необходимые значения и нажмите кнопку ОК.
- Если вы не хотите сохранять иллюстрации в распознанном тексте, убедитесь, что опция Сохранять картинки не отмечена.
При сохранении распознанного текста в формат PDF можно использовать стандартные шрифты Acrobat или системные шрифты, установленные на компьютере пользователя. Для того чтобы указать, какой набор шрифтов должен быть использован, в выпадающем списке Шрифт выберите:
- Использовать стандартные шрифты
При выборе данной опции PDF-файл содержит ссылку на стандартные шрифты Acrobat: TimesNewRoman, Arial, CourierNew. - Использовать системные шрифты
При выборе данной опции PDF-файл содержит ссылку на системные шрифты, установленные на компьютере пользователя.
- Нажмите кнопку Параметры защиты PDF… . В открывшемся диалоге вы можете установить необходимые параметры защиты. Подробнее см. «Параметры защиты PDF».
Как в файн ридер редактировать текст пдф
Замечание. Устанавливаемые в диалоге Шрифты цвет фона блока и форматирование текста малыми прописными (отображение всех строчных букв в выделенном тексте как прописных букв уменьшенного размера) не отображаются в окне Текст. Вы увидите эти изменения при сохранении документа в формате приложений, поддерживающих указанные типы форматирования текста.
Изменение выравнивания текста
- Выделите текст, который необходимо выровнять.
- Выполните одну из следующих операций:
- Нажмите на одну из кнопок , , , на панели Форматирование.
- Щелкните правой кнопкой мыши в окне Текст и в локальном меню выберите пункт Шрифт. В открывшемся диалоге Шрифт в поле Выравнивание выберите нужный пункт.
Отмена и восстановление действий
Выполните одну из следующих операций:
Как в файн ридер редактировать текст пдф
Результат распознавания отображается в окне Текст. В данном окне неуверенно распознанные символы выделяются цветом. Поэтому вы легко заметите возможные ошибки, и их исправление не займет много времени.
Вы можете редактировать полученный документ как непосредственно в окне Текст, так и с помощью встроенного диалога проверки орфографии Проверка (меню Опции…>Проверка…), который позволяет просматривать неуверенно распознанные слова, находить орфографические ошибки, добавлять в словарь новые слова, изменять язык словаря.
ABBYY FineReader также позволяет редактировать оформление полученного документа.
Вы можете форматировать полученные результаты в окне Текст с помощью кнопок, расположенных на главной панели инструментов и на панели Свойства текста (контекстное меню окна Текст>Свойства).
Замечание. В процессе распознавания в документе выделяются стили. Все выделенные стили отображаются на панели Свойства текста. Редактируя стили, вы можете легко изменять форматирование, применяемое к тексту. При сохранении текста в формат RTF/DOC/DOCX все используемые стили сохраняются.
Инструкция: как редактировать документы и распознавать тексты с иероглифами в ABBYY FineReader 15
PDF-документы давно стали необходимой составляющей офисной работы. В этом формате хранятся цифровые архивы, юристы согласуют договоры, дизайнеры верстают брошюры, издательства публикуют электронные книги. До недавнего времени главным достоинством и одновременно с этим недостатком PDF-документов было отсутствие возможности редактировать текст в них. Благодаря развитию технологий эту и другие задачи научилась решать программа ABBYY FineReader, которая стала многофункциональным редактором любых документов. «Хайтек» вместе с ABBYY рассказывает, как технологически устроено редактирование PDF-документов в новой версии FineReader 15, каким образом программа сравнивает версии документов и как работает распознавание иероглифов с помощью нейросетей.
Читайте «Хайтек» в
Диджитализация документооборота массово началась еще во второй половине ХХ века. Многие предприятия переходили на электронные документы. В офисах устанавливали первые компьютеры со специальным софтом для обработки и хранения важной информации. Тогда и появились популярные текстовые редакторы. Сотрудники набирали вручную документы, а затем, с появлением в 1993 году PDF, стали экспортировать их в этот формат. На первый взгляд казалось: если весь документооборот станет электронным, то о шкафах с бумажными каталогами и завалах на рабочих столах можно будет забыть. На практике оказалось, что чем больше организация использует компьютеры для цифрового документооборота, тем больше документов она печатает. 64% крупных компаний уверены, что по крайней мере до 2025 года печать будет значимой частью их бизнеса. С другой стороны, если сегодня в офис по традиционной почте приходит бумажный документ, его немедленно отсканируют и переведут в цифру. Как правило, сканы документов хранят в виде PDF-файлов. Документом в формате PDF удобнее пользоваться — его можно послать по электронной почте с уверенностью, что информация дойдет до адресата без искажений (если, конечно, кто-то не решит внести изменения собственноручно), и, в отличие от DOC, его трудно изменить. Это особенно важно, если речь идет о контрактах или коммерческих предложениях. Офисные сотрудники отмечают рост объемов использования PDF: каждый второй респондент ответил, что регулярно работает с документами в этом формате и нуждается в специализированной программе. За последние два года количество таких рабочих файлов в мире выросло в три раза — эти данные приводят эксперты IDC в исследовании «Addressing the document disconnect». В России PDF также пользуется популярностью. Также по результатам исследования ABBYY выяснилось, что в наиболее частые сценарии работы с PDF-документами вошли совершенно не типичные для этого формата ранее задачи: 52% респондентов вносят мелкие правки в текст PDF, исправляют ошибки или опечатки; 62% опрошенных часто ищут информацию в тексте PDF и 60% копируют текст из документа. Поэтому от программ, работающих с PDF, требуются новые возможности для редактирования, сравнения и распознавания текстов. Все они есть в новом FineReader 15.
Почему так сложно редактировать текст в PDF?
Изначально PDF не предназначался для того, что его каким-либо образом изменяли. Что было и его преимуществом — это безопасность, одинаковое отображение на любом устройстве и удобный способ обмена информацией, и недостатком — невозможность внесения правок, поиска по тексту и сравнения документов.
Особенности отображения текста в PDF
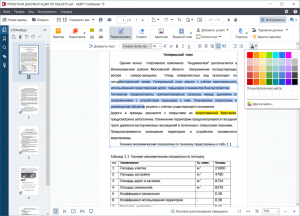
Несмотря на то, что PDF — это формат текста, в цифровом виде эти буквы, слова и предложения на самом деле не существуют, они «нарисованы». Содержимое хранится в виде потоков — это могут быть текст, изображения и векторная графика. Типичных для формата DOC слов, строчек, абзацев и таблиц в PDF нет. В формате нет и букв как таковых, а есть коды символов. Такие коды с одинаковыми характеристиками объединяются в группы по виду и размеру шрифта. Этот шрифт определяет, как символ должен отображаться в документе, сопоставляя код символа и глиф — набор команд для отрисовки. Еще одно отличие от обычного текстового документа — объекты в PDF существуют в трех измерениях. По координате Z судят о глубине расположения объекта на странице, ведь текст может находиться поверх изображения или наоборот. Текст в PDF-документе напоминает «мешочек букв», который нужно правильно отобразить в конкретных местах документа с соответствующим форматированием. С 2008 года PDF стал открытым форматом, что позволило разработчикам без проблем и дополнительных отчислений создавать программы для чтения файлов PDF, конвертеры и другие полезные вещи. Развитие OCR привело к тому, что у ранее неизменного PDF-документа появилась возможность редактирования — сначала построчного, а затем и в пределах абзацев. Если речь идет о digital-born-документе (изначально созданный на компьютере, а не отсканированный бумажный документ — «Хайтек»), то в режиме редактирования подключаются фоновые процессы, и программа приступает к анализу структуры документа. Для этого используется технология, которая строит блоки на основе данных, записанных в PDF, а не на основе распознавания. За считанные доли секунды технология должна пройти всю цепочку по определению параметров текста: места, где находятся заголовки, подзаголовки, отдельные абзацы и другие элементы. Потом — распихать «мешочки букв» по этим блокам, сформировать строки. Следующий этап — синтез. Специальные технологии определяют внешние параметры текста — отступы и межстрочные интервалы. Благодаря этому из хаотичной структуры снова появляется текстовый документ с форматированием. И уже в него можно вносить правки — менять слова и целые абзацы, исправлять форматирование, сохранять изменения и так далее.
Функция построчного редактирования уже была в предыдущей версии FineReader (ABBYY FineReader 14 вышла в январе 2017 года — «Хайтек»). Этого было достаточно, чтобы внести небольшие исправления в текст: заменить несколько букв или цифр. Новый ABBYY FineReader 15 стал универсальным текстовым редактором, в котором вносить изменения можно в целые абзацы.
Как отредактировать текст в отсканированном документе
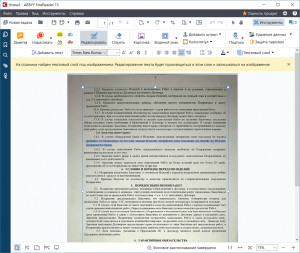
Отдельная офисная задача — отредактировать скан-копию бумажного документа. Раньше для этого пользователю приходилось конвертировать файл в редактируемый формат или просто искать исходник. Когда пользователь редактирует скан, ABBYY FineReader 15 в первую очередь распознает документ и создает временный текстовый слой на тех страницах, которые пользователь просматривает. В режиме редактирования создается текстовое представление страницы — именно его редактирует пользователь. Затем эти правки встраиваются в изображение страницы в отсканированном документе.
Как найти в PDF внесенные правки и избежать обмана
Сравнение документов — особо важный для бизнеса сегмент офисных задач. Прежде всего, потому что неожиданные правки могут стоить очень больших денег. Иногда их незаметно пытаются внести в уже подписанный договор и воспользоваться человеческой невнимательностью — такие документы обычно сравнивают юристы, внимательно вычитывая распечатки оригинала, созданного в Word, и ответа контрагента — отсканированный вариант. Поиск отличий в текстовых документах может быть полезен еще и в том случае, если над ними работают одновременно несколько человек или со временем один и тот же файл периодически изменяют. Это позволяет быстро найти последние правки, которые внесли в файл коллеги. В файлах DOCX для этого есть режим Track Changes, создающий на основе двух версий документа третью — с подсвеченными отличиями в тексте. В новом ABBYY FineReader 15 можно сохранить результаты сравнения любых документов в таком DOCX c Track Changes и в привычном режиме увидеть все различия. 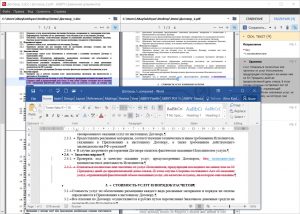 Сравнивать в ABBYY FineReader 15 можно практически что угодно — PDF, сканы или изображения, файлы DOC, DOCX и даже таблицы из Excel. В программу загружаются оба документа, которые при необходимости распознаются с помощью OCR. На основе извлеченного текста в документе определяются дополнительные элементы форматирования — например, колонтитулы, нумерация списков. В программе используется специальный алгоритм, который позволяет быстро выявлять отличия в версиях документов. Разностный алгоритм принимает два файла на вход. Первый, обычно более ранний — файл А, второй — файл B. Алгоритм определяет количество вставок или удалений, необходимых для превращения одного файла в другой, находя для этого кратчайший путь.
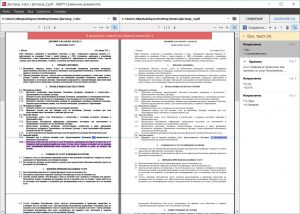 В завершении работы с документами программа объединяет обнаруженные различия в группы. Это необходимо, например, чтобы отделить внесенные исправления в основном тексте от колонтитулов и нумерации списка. В большинстве случаев колонтитулы не интересуют пользователя с точки зрения сравнения, за исключением вставок. Например, если у вас есть список на 100 позиций, в середине которого добавили или изменили один из пунктов. Чтобы работать с документом было удобнее, различия в нумерации попадают в отдельную группу. В финале пользователь может посмотреть все исправления в документе так, как ему удобно. На выбор есть несколько способов: сохранить новую версию документа в формате DOCX, где все изменения уже подсвечиваются в режиме Track Changes, получить PDF с комментариями в местах изменений или создать таблицу с перечнем правок в Word. Среди поддерживаемых ABBYY FineReader 15 функций:
- просмотр PDF-документов;
- редактирование текста в PDF-документе в пределах абзаца;
- удаление конфиденциальных данных;
- сравнение документов разного формата и написанных на разных языках;
- автоматизация задач по оцифровке и конвертации;
- распознавание и конвертирование документов;
- комментирование и согласование;
- защита и цифровая подпись.
Как работают нейросети для распознавания иероглифов и арабской вязи
Распознавание иероглифов осложняется тем, что в отличие от европейских языков, они состоят из большого количества черточек, палочек, наклонов. Но размер иероглифов вполне сопоставим с размером европейских букв. В низком разрешении сканов иероглифы могут и вовсе выглядеть как кляксы. Носитель языка поймет символ, исходя из контекста. Программа же работает поэтапно: сначала анализирует изображение всего документа, определяет абзацы, разбивает распознанные строки на слова, а слова — на отдельные символы. На этом этапе алгоритмы опираются не на контекст, как человек, а на внешний вид иероглифа, и здесь многое зависит от качества изображения. Для распознавания японского, китайского и корейского языков компания ABBYY внедрила нейросети. Они решают две главные задачи при работе с иероглифами — улучшение качества распознавания и «модернизацию» языков.
Качество и скорость в быстром и нормальном режиме
Внедрение нейросетей значительно повысило качество распознавания японского и китайского в быстром режиме, но скорость работы на начальном этапе разработки снизилась. Для клиентов, работающих с большим потоком документов, даже небольшая просадка по скорости может привести к сильному замедлению в обработке данных. Оказалось, что скорость проседает в документах с большим количеством символов с простой структурой — таких, как японская буквенная азбука (в современном японском языке используется три основных системы письма: кандзи — иероглифы китайского происхождения и две слоговые азбуки, созданные в Японии — хирагана и катакана — «Хайтек»).
Эту проблему решили с помощью кэша. Когда программа распознает страницу, одна и та же буква может попадаться на ней несколько раз. Встретив букву «А», написанную одним и тем же шрифтом, ABBYY FineReader анализирует и запоминает ее особенности. Этот принцип оптимизации позволяет не тратить время на распознавание одинаковых символов. Для японского и китайского ранее не использовался кэш, потому что встретить один и тот же иероглиф на странице, написанной естественным языком, можно очень редко. Но для символов с простой структурой это оказалось полезным. Включение кэша позволило ускорить и нормальный, и быстрый режим распознавания.
Почему важно следить за развитием языка
В предыдущих версиях FineReader в японском языке присутствовали иероглифы, которые уже не используются в современных документах. Это заметили сотрудники японского офиса ABBYY: время от времени программа вставляла при распознавании один-два устаревших символа. Для рядового носителя языка это воспринимается как буквы из русского дореволюционного алфавита для нас. Чтобы исправить эту ошибку, потребовалось создать в программе «новый язык» — Japanese Modern. Легко заставить программу не отображать те или иные устаревшие символы. Но необходимо было не просто выбросить ненужное, но и оставить всё необходимое, найти множество иероглифов, которые отображают всё богатство современного японского языка.
Новое множество символов формировалось в несколько этапов. Для тестирования создавали подходящие наборы изображений документов. Если в пакет попадала хотя бы одна страница с устаревшими формами, весь комплект оказывался непригодным. Приходилось вынимать эту страничку и формировать новый комплект материалов. Наконец удалось добиться того, чтобы в результатах распознавания почти не было устаревших символов и при этом правильно отображались все современные иероглифы.
Для китайского в FineReader всегда поддерживали традиционный и упрощенный языки. При этом по составу символов они не отличались. Получить разный результат распознавания всё равно было возможно, потому что в программе было заложено разное распределение вероятностей. В новой версии в результате экспериментов удалось выделить символы, необходимые для распознавания упрощенного китайского. В FineReader заложена возможность создавать пользовательский язык. Используя этот инструмент и внося изменения в состав, специалисты сравнивали результаты распознавания на разных образцах документов, и в результате в упрощенном китайском остался только необходимый набор иероглифов.
Корейская письменность, хангыль — нечто среднее между китайским и европейским письмом. Внешне это квадратные символы, напоминающие иероглифы, и на одной странице текста можно насчитать больше сотни уникальных. С другой стороны, это фонетическая письменность, то есть основанная на записывании звуков. Имеется алфавит, содержащий 24 буквы (плюс можно дополнительно посчитать диграфы и дифтонги). Но, в отличие от латиницы или кириллицы, звуки пишутся не в линию, а объединяются в блоки. Каждый блок может состоять из двух, трех или четырех букв. Первой всегда идет согласная, затем одна или две гласных, и в конце может стоять еще одна согласная. Для корейского обучили отдельную нейросеть, которая, помимо корейских слогов, распознает и некоторые иероглифы. Вместо распознавания символов целиком технология определяет отдельные буквы в них.
Как резать арабскую вязь на фрагменты
Арабский язык отличается от других тем, что найти линии порезки между символами в арабской вязи очень сложно. Даже гистограмма при распознавании арабского отличается: выглядит как бесконечный набор горбиков и ямочек.
Варианты разделения текста на символы создаются всегда, даже для европейских языков. В процессе работы программа выбирает наиболее вероятный путь распознавания. В случае с арабским языком таких вариантов очень много, и это приводило к ошибкам. Поэтому для повышения точности программу научили видеть не отдельную букву, а всё слово целиком. Для этого была разработана сеть end-to-end (e2e). Она полезна не только для арабского, но и для европейских языков — например, в дизайнерских шрифтах, когда на изображениях сложно построить путь для распознавания.
При e2e-подходе на вход в нейросеть поступает набор изображений — фрагментов, состоящих из отдельных слов. На выходе такая нейросеть выдает последовательность графем, которые затем проходят дополнительную обработку: проводится словарный анализ, корректируются пробелы.
Для обучения использовался набор из нескольких сотен тысяч фрагментов — отдельные слова из отсканированных газет, журналов, официальных документов. Они были выбраны в несколько итераций: сначала собирали базу из слов, которые удачно распознали, и обучали нейросеть на этом датасете. Потом еще раз обучали, корректировали, выявляли ошибки. Часть, которую не смогли распознать, отдельно отдавали на доразметку и корректировку фрагментов. В результате всё больше очищали датасет для обучения, улучшая общее качество распознавания.
Кроме того, часть данных для обучения была создана искусственно. Это было необходимо для распознавания шрифтов, для которых было собрано мало образцов. В таких случаях использовался корпус текста, в который добавлялись различные искажения, типичные для этапа сканирования документа: шум, размытие символа. Это делала в автоматическом режиме специальная программа — генератор синтетики, или «портилка».
Сначала в ходе обучения такой подход привел к тому, что потерялась информация об охватывающих прямоугольниках символов, которые необходимо отображать для пользователя на этапе верификации. Отказавшись от посимвольного распознавания, пришлось внедрить альтернативный механизм, который дополнял результаты распознавания информацией об охватывающих прямоугольниках и резал слова на отдельные символы.
Сочетание новых алгоритмов машинного обучения сделало возможным создание многофункционального текстового редактора для работы с PDF, сканами и digital-born-документами. Внесение правок, сравнение файлов и распознавание сложных языков дает пользователю возможность полноценно работать с файлами вне зависимости от их формата. По сути, это позволяет охватить все спектры офисных задач по работе с электронными и даже бумажными документами, максимально упрощая работу сотрудникам и снижая вероятность ошибок из-за человеческого фактора.