Как создать свой язык программирования? Теория и практика

Создание языка программирования очень сложная задача, но выполнимая. Мы расскажем основные факторы при создании своего первого языка.
Желание создать что-то своё и оставить след в истории посещает всех людей, в том числе программистов. Создание собственного языка программирования – это подходящая возможность. Мотивы бывают различные: от нечего делать, решения вечных проблем в других языках, разработка комфортного варианта для себя.
Создание языков – это посильная задача, которую может выполнить читатель, руководствуясь пошаговым алгоритмом из 12 этапов. Вероятно, что именно за вашим языком будущее.
Статья содержит специфические термины, без понимания которых не обойтись: лексеры, парсеры, интерпретаторы, компиляторы, деревья синтаксиса и остальное. Значительно проще вникнуть в суть, черпая информацию из интернета или при совместном изучении данных с опытным программистом. Базовые понятия терминологии – это фундаментальная величина для создания своего языка программирования.
Изучение компьютера
Это совет и необходимость одновременно, знание операционных систем поможет работать, изучать новые языки, стать на путь программиста. Невозможно создать быстрый, качественный и многофункциональный язык без понимания способа преобразования кода и его обработки. Познание функционирования системной машины – это обязательный этап дальнейшего развития.
Зачем вам новый язык программирования?
Заранее определитесь с предназначением языка. Существует 2 основных направления – универсальный инструмент или узкоспециализированное решение.
Востребованными оказываются языки с обоих направлений, но более популярны универсальные. Учтите, что многофункциональные языки требуют больше времени и усилий, а также у них множество конкурентов.
Сейчас стоит оценить количество предстоящей работы, установить цели и желания. Немаловажно определиться, вы планируете стать знаменитостью, а язык должен стать одним из лучших, или вам достаточно интересно провести время и расширить мировоззрение?
Каких концепций будет придерживаться новый язык?
На этапе планирования следует ответить на ряд ключевых вопросов, они зададут направление развития:
- интерпретация или компиляция? Код для компилирования будет преобразовываться в машинный, затем исполняться. При использовании интерпретатора код обрабатывается построчно. На вопрос нет правильного ответа, перед разработчиком стоит сложный выбор, в какую сторону уклон делать: функциональность, безопасность, скорость работы, удобство и т. д.;
- типизация? Если да, то разработчику будет необходимо вручную устанавливать типы данных. В противном случае придётся описывать систему, которая будет определять типы;
- в языке будет встроен автоматический алгоритм очистки мусора или управление отдать в руки пользователя?
- планируемая модель языка программирования: структурное, ООП, функциональная логика. Кто знает, может вам удастся разработать что-то совсем иное;
- как язык будет себя вести в отношении конкурентов, вставка из других языков планируется? Учитывать этот аспект важно при изначальной разработке языка;
- планируется поддержка базового функционала языка или передать все функции на сторону фреймворков?
- какой ожидается конечный вид архитектуры программы?
Последовательно отвечая на поставленные вопросы, в голове начнёт формировать облик детища, но появятся и другие вытекающие вопросы, требующие ответов.
Придумайте синтаксис для языка
При использовании особых символов можно существенно упростить работу компьютеру и повысить производительность кода. Недостатком является отталкивание нового пользователя. Подобный выбор стоит в отношении функций: либо элементарные и понятные, либо максимально информативные.
При этом синтаксис может быть каким вы только сами захотите. К примеру, существует язык от отечественных разработчиков, который называется YoptaScript . Он имеет очень забавный синтаксис и писать программы на нем приносит лишь смех 🙂

PS: этот язык является лишь шуткой и его не стоит воспринимать как реальный язык. Посмотреть язык вы можете на их официальном сайте .
Назовите ваше детище
Вопрос с одной стороны простой, с другой – нет. Многие разработчики не выбирают глубокое и замысловатое название, отдают предпочтение простоте и лёгкости запоминания. Особенно эффективно давать имя языку с явной ассоциацией, чтобы потенциальный пользователь запоминал название после первого-второго произнесения. Сложные аббревиатуры и названия из 3 и больше слов – сложно запоминаются и быстро теряются в памяти. Имя должно быть относительно коротким и запоминающимся.
Выберите фундамент языка
Выбор языка, который будет взят за основу – это важнейший шаг. Если знаний достаточно, можно писать на ассемблере или даже машинном коде, но в современном мире лучше присмотреться к другим высокоуровневым языкам: C, C++ , Swift , Pascal и другие компилируемые варианты пригодные для интерпретируемых решений. В качестве достойных языков с интерпретаторами стоит присмотреться к: Java , JavaScript , Ruby, Python – для компиляторов. Перечисленные пары снизят потерю скорости работы.
Лексер и парсер
Лексер – это инструмент для анализа лексики, деления написанного кода на отдельные элементы, их называют токены. Далее вступает в работы парсер для синтаксического анализа, его роль – организация иерархии с учётом токенов, он восстанавливает цепь событий. В качестве графического примера рассмотрим простую схему:


Пугаться не стоит, так как уже есть готовые библиотеки для быстрого формирования лексеров и парсеров. Приложения упростят выполнение сложного этапа работы.
Создание основной библиотеки
Независимо от наличия встроенных возможностей в языке для работы с элементарным функционалом или максимального использования внешних библиотек, потребуется создание функций. Они помогут продемонстрировать возможности хотя бы очень базисно.
Создание и написание тестов
Процесс создания в большей мере сводится к оттачиванию работы, так как сформировать нормально работающий язык весьма сложно. Задача разработчика – выявить работоспособность встроенных элементов и механизмов их взаимодействия, здесь на помощь приходят тесты. По результатам тестирования делается вывод о недопустимом и разрешённом синтаксисе и сочетании функций. Возможно удастся расширить функционал языка.
Выпуск языка в свет
После завершения работы обязательно следует загрузить язык в сеть. Здесь вы найдёте единомышленников и людей, которые помогут совершенствовать детище. Публикация – это логическое завершение процесса, не стоит прятать работу в ящик, поделитесь ей.
Больше интересных новостей

Почему расширения Google Chrome никому не нужны?

ТОП-5 инструментов для хранения паролей
6 новых языков программирования, что достойны вашего внимания
5 топовых пасхалок от Google, о которых должен знать каждый
Комментарии (2)
Хёни(талшын) 20 февраля 2023 в 18:00
Я буду создать свою языку
Сергей 24 декабря 2022 в 18:22
как написать свой язык программирования на пайтон
Python является одним из самых популярных языков программирования в мире благодаря своей простоте и мощности. Одной из самых захватывающих возможностей Python является возможность создания собственного языка программирования. Несмотря на то, что это может показаться сложным, с использованием Python вы можете создать свой собственный язык программирования, который будет соответствовать вашим потребностям и задачам. В этой статье мы рассмотрим основные шаги, которые вам потребуются, чтобы создать свой язык программирования на Python.
Шаг 1: Определите грамматику вашего языка
Первым шагом в создании собственного языка программирования является определение грамматики. Грамматика является набором правил, описывающих синтаксис вашего языка. Например, вы должны определить, каким образом обозначаются переменные, условные операторы, циклы и т.д. Существует множество инструментов, таких как ANTLR или PLY, которые могут помочь вам определить и реализовать грамматику вашего языка.
Шаг 2: Создайте лексер и парсер
После определения грамматики, вы должны создать лексер и парсер для вашего языка. Лексер разбивает входной текст на отдельные лексемы или токены, такие как идентификаторы, операторы или числа. Парсер анализирует последовательность лексем, чтобы установить синтаксическую структуру вашего языка. Вы можете использовать инструменты, такие как PLY или PyParsing, для реализации лексера и парсера на Python.
Шаг 3: Определите абстрактное синтаксическое дерево (АСД)
Абстрактное синтаксическое дерево (АСД) представляет структуру вашего программного кода в виде дерева, где каждый узел представляет конкретную конструкцию языка, такую как оператор, выражение или блок кода. АСД является промежуточным представлением кода вашего языка и будет использоваться для выполнения или компиляции программ. Вы можете определить АСД с использованием библиотеки AST (абстрактное синтаксическое дерево) Python или создать свою собственную структуру данных.
Шаг 4: Реализуйте интерпретатор или компилятор
После определения АСД вы должны реализовать интерпретатор или компилятор для вашего языка. Интерпретатор выполняет программу непосредственно на основе АСД, в то время как компилятор переводит программу в машинный код или другой язык программирования. В Python вы можете использовать библиотеку для выполнения программного кода из АСД или использовать инструменты, такие как LLVM, для создания компилятора.
Шаг 5: Проверьте и оптимизируйте ваш язык
После создания своего языка программирования важно проверить и оптимизировать его производительность и функциональность. Вы можете создать тестовые сценарии и провести ряд тестов, чтобы проверить, работает ли ваш язык как ожидалось. Вы также можете внедрить различные оптимизации, чтобы улучшить производительность и эффективность вашего языка.
В заключение, создание собственного языка программирования на Python может быть интересным и захватывающим опытом. С помощью правильных инструментов и шагов вы можете создать язык, который соответствует вашим потребностям и позволяет вам выразить свое видение программирования. Сейчас вы вооружены базовыми знаниями по созданию собственного языка программирования на Python и готовы начать свое творчество в мире разработки программного обеспечения!
Пишем свой язык программирования без мам, пап и бизонов. Часть 0: теория
Тема написания своего ЯПа не дает мне покоя уже около полугода. Я не ставил перед собой цель «убить» CoffeeScript, TypeScript, ELM, тысячи их, я просто хотел понять кухню и как они вообще пишутся.
К моему неприятному удивлению, большинство из этих языков используют Jison (Bison для JavaScript), а это не совсем попадало под мою задачу — «понять», так как по сути дела Jison делает все за вас, собирает AST по заданным вами правилам (Jison как таковой отличный инструмент, который делает за вас львиную долю работы, но сейчас не о нем).
В конечном итоге я методом проб и ошибок (а если сказать точнее, чтения статей и реверс инжиниринга) научился писать свои полноценные языки программирования от разбития исходного текста на лексемы до его трансляции в JS код.
Стоит заметить, что данное руководство не привязано к JavaScript, он выбран исключительно из соображений скорости разработки и читаемости, так что вы можете написать свой «лисп»/»питон»/»ваш абсолютно новый синтаксис» на любом знакомом вам языке.
Также до момента написании компилятора (в нашем случае транслятора), процесс написания языка не отличается от процессов создания языков компилируемых в ASM/JVM bitcode/LLVM bitcode/etc, а это значит, что данное руководство не ограничивается созданием языка трансляцируемого в JavaScript.
Весь код, который будет написан в данной (и последующих статьях), лежит на Github’е. Тегами обозначены начало и концы статей для удобства.
Немного теории
Не углубляясь в википедийность, процесс трансляции исходного кода в конечный JS код протекает следующим образом:
source code -(Lexer)-> tokens -(Parser)-> AST -(Compiler)-> js codeЧто тут происходит:
1) Lexer
Исходный код нашей программы разбивается на лексемы. По-простому это нахождение в исходном тексте ключевых слов, литералов, символов, идентификаторов и т.д.
Т.е. на выходе из этого (CoffeeScript):
a = true if a console.log('Hello, lexer')Мы получаем это (сокращенная запись):
[IDENTIFIER:"a"] [ASSIGN:"="] [BOOLEAN:"true"] [NEWLINE:"\n"] [NEWLINE:"\n"] [KEYWORD:"if"] [IDENTIFIER:"a"] [NEWLINE:"\n"] [INDENT:" "] [IDENTIFIER:"console"] [DOT:"."] [IDENTIFIER:"log"] [ROUND_BRAKET_START:"("] [STRING:"'Hello, lexer'"] [ROUND_BRAKET_END:")"] [NEWLINE:"\n"] [OUTDENT:""] [EOF:"EOF"]Так-как CoffeeScript отступо-чувствительный и не имеет явного выделения блока скобками < и >, блоки отделяются отступами ( INDENT ом и OUTDENT ом), которые по сути заменяет скобки.
2) Parser
Парсер составляет AST из токенов (лексем). Он обходит весь массив и рекурсивно подбирает подходящие паттерны, основываясь на типи токена или их последовательности.
Из полученных токенов в пункте 1, parser составит, примерно такое дерево (сокращенная запись):
< type: 'ROOT', // Основная нода нешего дерава nodes: [< type: 'VARIABLE', // a = true id: < type: 'IDENTIFIER', value: 'a' >, init: < type: 'LITERAL', value: true >>, < type: 'IF_STATEMENT', // Условное выражение test: < type: 'IDENTIFIER', value: 'a' >, consequent: < type: 'BLOCK_STATEMENT', nodes: [< type: 'EXPRESSION_STATEMENT', // Вызов console.log expression: < type: 'CALL_EXPRESSION', callee: < type: 'MEMBER_EXPRESSION', object: < type: 'IDENTIFIER', value: 'console' >, property: < type: 'IDENTIFIER', value: 'log' >>, arguments: [< type: 'LITERAL', value: 'Hello, lexer' >] > >] > >] >Не стоит пугаться объема дерева, на деле он генерируется рекурсивно и его создание не вызывает трудностей.
3) Compiler
Построение конечного кода по AST. Этот пункт можно заменить на компиляцию в байткод, или даже рантайм, но в рамках данной серии статей мы рассмотрим реализацию транслятора в другой язык программирования.
Компилятор (читай транслятор) преобразует Абстрактно-Синтаксическое Дерево в JavaScript код:
var a = true; if (a)
Вот и все. Большинство компиляторов работают именно по такому принципу (с незначительными изменениями. Иногда добавляют процесс стримминга исходного текста в поток символов, иногда напротив объединяют парсинг и компиляцию в один этап, но не нам их судить).
Habrlang
Итак, разобравшись с теорией, нам предстоит собрать свой язык программирования, у которого будет примерно следующий синтаксис (что-бы не особо париться, мы будем делать смесь из Ruby, Python и CoffeeScript):
#!/bin/habrlang # Hello habrlang def hello В следующей главе вы реализуем все основные классы нашего транслятора, и научим его транслировать комментарии Habrlang'а в JavaScript.
Как я за месяц написал интерпретируемый язык программирования на Python
Привет, Хабр! В этой статье я хотел бы поделиться опытом создания своего языка программирования.
Предыстория
Мне 14. Обучаясь на втором году Яндекс Лицея, нужно было написать несколько проектов. Первым из них стал проект на PyQT5. Я долго думал над идеей и вспомнил, что летом я хотел создать свой язык, но у меня этого не получилось (Тогда я не понимал как работает парсер и абстрактное синтаксическое дерево, поэтому забросил). И вот, мне пришла идея - сделать свой язык программирования и написать для него IDLE (т.к. тема проекта все-таки QT). Ещё полгода назад я изучал асинхронность и многопоточность, поэтому именно одну из этих идей я хотел воплотить в своём языке. В данной статье я хотел рассказать устройство интерпретируемых языков и как их создать.
Чем отличается интерпретируемый язык от компилируемого
Вся разница в исполнении кода. Интерпретируемые языки работают по следующей схеме:
Lexer.py ---> Parser.py ---> AbstractSyntaxTree.py ---> resultНиже я более подробно рассказываю про работу всех компонентов кроме AST, потому что на момент написания языка я не понимал как это работает.
Компилируемые языки программирования исполняют код не построчно (как интерпретируемые). Процесс компиляции включает препроцессинг исходного кода, где удаляются комментарии и вставляются содержимое файлов, компиляцию кода в ассемблерный или промежуточный код, а затем ассемблирование этого кода в машинный код, который линкуется в исполняемый файл с разрешением внешних ссылок. Проще говоря, написанный код переводится либо на ассемблер, либо на другие компилируемые языки, которые его исполняют.
Устройство языка
Я решил, что мой язык будет состоять только из Лексера и Парсера (окончательное понимание синтаксического дерева пришло ко мне под конец). Я сразу отказался использовать такие библиотеки, как PLY и RPLY, поэтому мой проект написан на чистом Python. Про компоненты языка я буду объяснять неформально, то-есть так, как понял это я.
Лексер
В каждом языке программирования есть Лексер и Парсер. Лексер - класс, который принимает строку кода и разбивает её на токены. Токены нужны для проверки грамматики на этапе парсинга.
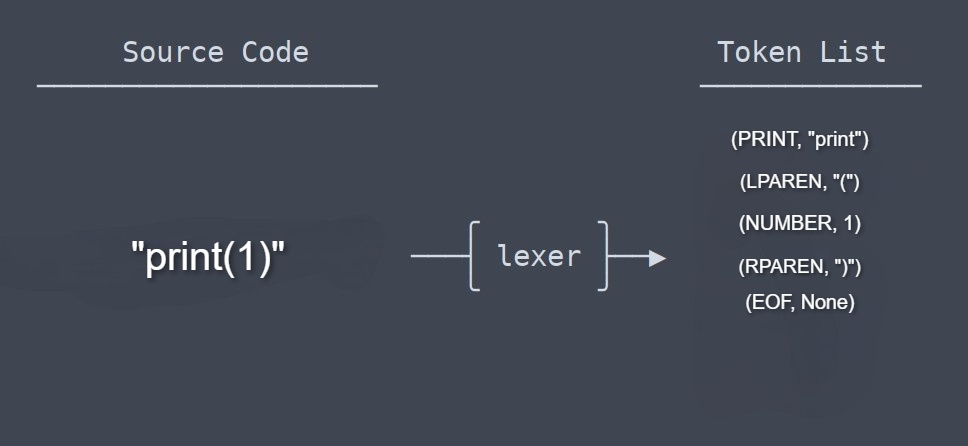
Токены, которые представлены на картинке, являются объектами класса Token, Данный класс принимает в __init__: тип токена и его значение.
NUMBER = "NUMBER" STRING = "STRING" class Token: def __init__(self, type, value): self.type = type self.value = value def __str__(self): return f'Token(, )' def __repr__(self): return self.__str__()Помимо класса Token, есть вышеупомянутый класс Lexer, который посимвольно проходит строку циклом и возвращает объекты класса Token:
class Lexer: def __init__(self, text): self.text = text self.pos = 0 self.current_char = self.text[self.pos] def advance(self): self.pos += 1 if self.pos < len(self.text): self.current_char = self.text[self.pos] else: self.current_char = None def return_pos(self, pos): self.pos = pos if self.pos < len(self.text): self.current_char = self.text[self.pos] else: self.current_char = None def skip_whitespace(self): while self.current_char is not None and self.current_char.isspace(): self.advance() def get_next_token(self): while self.current_char is not None: if self.current_char.isspace(): self.skip_whitespace() continue if self.current_char.isdigit() or self.current_char == "-": token_value = "" while self.current_char is not None and (self.current_char.isdigit() or self.current_char == "." or self.current_char == "-"): token_value += self.current_char self.advance() try: return Token(NUMBER, int(token_value)) except: try: return Token(NUMBER, float(token_value)) except: return Token(MINUS, "-") if self.current_char == '"' or self.current_char == "'": self.advance() string_value = "" while self.current_char is not None and self.current_char != '"' and self.current_char != "'": string_value += self.current_char self.advance() if self.current_char == '"' or self.current_char == "'": self.advance() return Token(STRING, '"' + string_value + '"') else: print(f"Некорректный символ: ") sys.exit() if self.current_char == '=': self.advance() return Token(ASSIGN, '=') if self.current_char == '+': self.advance() return Token(PLUS, '+') if self.current_char == '-': self.advance() return Token(MINUS, '-') if self.current_char == '*': self.advance() return Token(MULTIPLY, '*') if self.current_char == '/': self.advance() return Token(DIVIDE, '/') if self.current_char == '%': self.advance() return Token(PR, '%') if self.current_char == '(': self.advance() return Token(LPAREN, '(') if self.current_char == ')': self.advance() return Token(RPAREN, ')') if self.current_char == '^': self.advance() return Token(DEG, '^') if self.current_char == ',': self.advance() return Token(COMMA, ',') if self.current_char.isalpha(): token_value = "" while self.current_char is not None and (self.current_char.isalpha() or self.current_char.isdigit() or self.current_char == "_"): token_value += self.current_char self.advance() if token_value == "int": return Token(INT, "int") elif token_value == "float": return Token(FLOAT, "float") elif token_value == "str": return Token(STR, "str") elif token_value == "None": return Token(NONE, "None") elif token_value == "print": return Token(PRINT, "print") elif token_value == "input": return Token(INPUT, "input") elif token_value == "True" or token_value == "False": return Token(BOOL, token_value) else: return Token(VAR, token_value) print(f"Неверный синтаксис: ") sys.exit() return Token(EOF, None)Это лишь половина класса Лексера. Он проходится по каждому символу и проверяет его существование. Если Лексер нашёл символ, то возвращает объект класса Token с переданными типом символа и самим символом. Помимо этого существуют ещё три класса, которые хранят значения локальных переменных и код функций:
Парсер
Парсер, по моему мнению, является сложнейшей частью языка. В моём случае он выполняет задачу проверки синтаксиса и исполнения кода. Вот частичный код получившегося класса:
import math from lexer import * # Определение парсера для вычисления выражений class Parser(): def __init__(self, lexer, symbol_table): """ Конструктор класса Parser. Параметры: - lexer: экземпляр класса Lexer для токенизации входного текста. - symbol_table: экземпляр класса SymbolTable для отслеживания переменных. symbol_table - объект класса SymbolTable, используется для хранения и управления переменными. """ self.lexer = lexer self.current_token = self.lexer.get_next_token() self.symbol_table = symbol_table def eat(self, token_type): """ Функция проверяет текущий токен и токен, с которого мы хотим перейти на другой токен. То есть у нас не получиться будучи на Token(VAR, "x") перейти на следущий токен с того, которого мы передаём в функцию: Текущий токен: VAR, мы передали в функцию токен PRINT - получаем ошибку, потому что мы находимся на токене VAR, а хотим перейти на следующий токен с токена PRINT. """ if self.current_token.type == token_type: self.current_token = self.lexer.get_next_token() else: raise Exception(f"Error eating token!") def factor(self): """ Функция отвечает за использование встроенных функций языка или других токенов которые возвращают значения: . = input() . = int(x) . = True """ token = self.current_token if token.type == NUMBER: self.eat(NUMBER) return token.value elif token.type == STRING: string_value = token.value self.eat(STRING) return string_value elif token.type == NONE: self.eat(NONE) return None elif token.type == BOOL: result = token.value if result == "True": result = True else: result = False self.eat(BOOL) return result elif token.type == VAR: var_name = token.value self.eat(VAR) return self.symbol_table.lookup(var_name) elif token.type == INT: self.eat(INT) self.eat(LPAREN) result = int(self.expr()) self.eat(RPAREN) return result elif token.type == FLOAT: self.eat(FLOAT) self.eat(LPAREN) result = float(self.expr()) self.eat(RPAREN) return result elif token.type == STR: self.eat(STR) self.eat(LPAREN) result = str(self.expr()) self.eat(RPAREN) return result elif token.type == LPAREN: self.eat(LPAREN) result = self.expr() self.eat(RPAREN) return result def term(self): """ Обработка терма (произведения или частного). Возвращает: - Результат вычисления терма. """ result = self.factor() while self.current_token.type in (MULTIPLY, DIVIDE, PR, DEG): token = self.current_token if token.type == MULTIPLY: self.eat(MULTIPLY) result *= self.factor() elif token.type == DIVIDE: self.eat(DIVIDE) result /= self.factor() elif token.type == PR: self.eat(PR) result %= self.factor() elif token.type == DEG: self.eat(DEG) num = self.factor() result = math.pow(result, num) return result def expr(self): """ Обработка выражения (суммы или разности). Возвращает: - Результат вычисления выражения. """ result = self.term() while self.current_token.type in (PLUS, MINUS): token = self.current_token if token.type == PLUS: self.eat(PLUS) result += self.term() elif token.type == MINUS: self.eat(MINUS) result -= self.term() return result def statement(self): """ Функция отвечает за встроенные функции и конструкции, которые не возвращают значения: print() var = . if . """ if self.current_token.type == VAR: var_name = self.current_token.value self.eat(VAR) if self.current_token.type == ASSIGN: self.eat(ASSIGN) value = self.expr() self.symbol_table.define(var_name, value) else: sys.exit() elif self.current_token.type == PRINT: self.eat(PRINT) self.eat(LPAREN) values = [] while self.current_token.type != EOF and self.current_token.type != RPAREN: values.append(self.expr()) if self.current_token.type == COMMA: self.eat(COMMA) self.eat(RPAREN) print(*values) else: self.current_token = self.lexer.get_next_token() def parse(self): """ Парсинг входного текста и выполнение выражений. Эта функция запускает парсинг входного текста и последовательно выполняет выражения, включая присваивание переменных и вывод значений. """ while self.current_token.type != EOF: self.statement()Теперь рассмотрим на примере, как работает класс. На вход подаётся строка:
x = 5Она проходит через лексер:
Token(VAR, "x") Token(ASSIGN, " python">Token(VAR, "x") ---> self.parse() ---> self.statement() ---> self.expr() ---> self.term() ---> self.factor() | | x = На вход поступает первый токен — Token(VAR, «x»). Класс запускается при использовании функции self.parse(). Функция self.parse() вызывает функцию self.statement(), которая вызывает функцию self.expr() и ждет от неё возвращаемое значение. Функция self.expr() вызывает self.term() и тоже ждёт возвращаемое значение и т.д.
Возникшие проблемы
Основными проблемами стали GIL и низкая скорость Python. Язык работал слишком медленно (Был вариант переписать на C++, но приближалась сдача проекта), а параллельные циклы, реализованные с помощью asyncio, не работали вовсе (т.к. в моём случае корутины не работали из-за блокируемых операций). Asyncio пришлось заменить библиотекой multiprocessing, которая запускает несколько Python интерпретаторов. Проблему с низкой скоростью я решил с помощью Cython. Он помог разогнать язык в 90 раз! Поэтому, если вы захотите написать что-нибудь на моём языке, Вам придётся установить Cython и выполнить компиляцию файлов .pyx (делается это просто, расписал инструкцию в репозитории).
Выводы
В этой статье я постарался рассказать, как работают интерпретируемые языки программирования. Язык я завершил после добавления функций и многопоточных циклов. документацию, примеры и код к языку вы можете найти в моём репозитории. На написание данной статьи меня подтолкнуло малое количество информации на подобную тему. Буду рад комментариям и Вашим замечаниям. До скорых встреч!
- языки программирования
- интерпретаторы
- как написать свой язык