Как измерить время выполнения скрипта Python
Допустим, вы хотите знать время выполнения следующего кода Python:
a = range(100000) b = [] for i in a: b.append(i*2)Есть несколько способов измерить время, необходимое для выполнения скрипта Python, но вот лучший способ сделать это, и я объясню почему:
import timeit code_to_test = """ a = range(100000) b = [] for i in a: b.append(i*2) """ elapsed_time = timeit.timeit(code_to_test, number=100)/100 print(elapsed_time)В консоли получим: 0.01137321546
Это вывод, который я получаю на своем Macbook Pro. Итак, это более или менее 1/100 секунды.
Как работает вышеуказанный скрипт
Строка 1: мы импортируем модуль timeit . Строка 3: мы создаем переменную. В этой переменной мы храним код, который хотим протестировать. Этот код должен идти внутри тройных кавычек. Итак, тестовый код предоставляется в виде строки. Строка 10: мы вызываем функцию time.timeit() . Функция timeit() получает тестовый код в качестве аргумента, выполняет его и записывает время выполнения. Чтобы получить точное время, я приказал timeit() выполнить 100 циклов. Поэтому мне пришлось разделить вывод на 100, чтобы получить время выполнения только для одного цикла. Строка 11: мы просто распечатываем время выполнения. Результат — время выполнения в секундах.
Почему timeit() — лучший способ измерить время выполнения кода Python?
1. timeit() автоматически будет использовать time.clock() или time.time() для вас в фоновом режиме, в зависимости от того, какая операционная система вам нужна для получения наиболее точных результатов.
2. timeit() отключает сборщик мусора, который может исказить результаты.
3. timeit() повторяет тест много раз (в нашем случае 100 раз), чтобы минимизировать влияние других задач, выполняемых в вашей операционной системе.
Упражнение:
Кстати, код, который мы тестировали выше, строит список путем умножения элементов другого списка. Я могу достичь того же результата, используя range :
a = range(100000) b = [i*2 for i in a] Если вам больше нечем заняться и попробуйте выполнить упражнение, попробуйте измерить время выполнения приведенного выше кода с помощью timeit() .
Наконец, совет: закрывайте тяжелые программы, которые запускаются на вашем компьютере, когда вы выполняете такие тесты, чтобы вы получили еще более точные результаты, которые не зависят от тяжелых задач процессора.
Источник:
Python как измерить время выполнения кода
На этом шаге мы рассмотрим использование модуля timeit .
Модуль timeit позволяет измерить время выполнения небольших фрагментов кода с целью оптимизации программы. Прежде чем использовать модуль, необходимо подключить его с помощью инструкции:
from timeit import Timer
Измерения производятся с помощью класса Timer . Конструктор класса имеет следующий формат:
Timer([stmt='pass'][, setup='pass'][, timer=])
В параметре stmt указывается код (в виде строки), время выполнения которого предполагается измерить. Параметр setup позволяет указать код, который будет выполнен перед измерением времени выполнения кода в параметре stmt . Например, в параметре setup можно подключить модуль.
Получить время выполнения можно с помощью метода timeit ([number=1000000]) . В параметре number указывается количество повторений. Для примера просуммируем числа от 1 до 10000 тремя способами и выведем время выполнения каждого способа.
#-*- coding: utf-8 -*- from timeit import Timer code1 = """\ i, j = 1, 0 while i < 10001: j += i i += 1 """t1 = Timer(stmt=code1) print("while:", t1.timeit(number=10000)) code2 = """\ j = 0 for i in range(1, 10001): j += i """ t2 = Timer(stmt=code2) print("for:", t2.timeit(number=10000)) code3 = """\ j = sum (range(1, 10001)) """ t3 = Timer(stmt=code3) print("sum:", t3.timeit(number=10000)) input ()
Архив с файлом можно взять здесь.
Примерный результат выполнения (зависит от мощности компьютера):
while: 25.13958657675797 for: 14.858756346126274 sum: 5.050326964385583
Как видно из результата, цикл for работает почти в два раза быстрее цикла while , а функция sum () в данном случае является самым оптимальным решением задачи.
Метод repeat ([repeat=3] [, number=1000000]) вызывает метод timeit () указанное количество раз (задается в параметре repeat ) и возвращает список значений. Аргумент number передается в качестве параметра методу timeit () . Для примера создадим список со строковыми представлениями чисел от 1 до 10000. В первом случае для создания списка используем цикл for и метод append () , а во втором — генератор списков.
# -*- coding: utf-8 -*- from timeit import Timer code1 = """\ arr1 = [] for i in range(1, 10001): arr1.append(str(i)) """ t1 = Timer(stmt=code1) print("append:", t1.repeat(repeat=3, number=2000)) code2 = """\ arr2 = [str(i) for i >in range(1, 10001)] """ t2 = Timer(stmt=code2) print("генератор:", t2.repeat(repeat=3, number=2000)) input()
Архив с файлом можно взять здесь.
Примерный результат выполнения:
append: [12.780722522318046, 12.724886804338505, 12.903999274243034] генератор: [10.290514465192551, 10.268080216531082, 10.219959743593058]
Как видно из результата, генераторы списков работают быстрее.
Со следующего шага мы начнем рассматривать пользовательские функции .
Python как измерить время выполнения кода
print(«— %s seconds —» % (time.time() — start_time))
Более безопасный способ, потому что time.monotonic() никогда не идёт назад, даже если на машине будет переведено время:
from datetime import timedelta
- Закодировать файл в base64 на Python
- Рекурсивное создание директорий в Python
- Сортировка в Python
- Правильно добавить год/месяц к дате в Python
- Отформатировать дату в Python
- Получить рабочую директорию и директорию со скриптом в Python
- Копия объекта в Python
- Время выполнения программы на Python
- Конвертировать datetime.timedelta в строку
- Парсинг даты в Python
- Конвертировать строку (str) в булевый тип (bool) в Python
- Получить местный часовой пояс в Python
- Проверить, что строка соответствует регулярному выражению в Python
- Просмотреть доступные версии модулей в PIP
- Получить целочисленный Unix timestamp в Python
- getter и setter в Python
- Настроить формат вывода логов в Python
- Получить переменную окружения в Python
- Обновить пакет в PIP
- Получить имя (хостнейм) машины из Python
- Вывести стэк вызовов при возникновении исключения в Python
- Функция eval в Python
- Дозаписывать (append) в файл в Python
- Препроцессинг кода в Python
- Проверить, что программа установлена из Python
- Настроить путь для импорта библиотек в Python
- Получить размер терминала в символах в Python
- Enum с дополнительными полями в Python
- Ошибка invalid command ‘bdist_wheel’ при установке пакета через PIP
- Получить список аргументов функции из Python
- Сделать словарь только для чтения в Python
- Заматчить любой символ, включая перевод строки, в регулярных выражениях на Python
- Получить список файлов в директории через pathlib в Python
- Вывести действительное число с округлением до нескольких символов после запятой в Python
- Вывод в терминал текста с цветами в Python
- Перезагрузить импортированный модуль в Python
- Безопасно создать список/словарь/любой объект из строкового представления в Python
- Аналог декоратора @property для методов класса в Python
- Перехватить ошибку TimeoutError в asyncio
- Отключить вывод логов в Python
- Уровни логгирования в Python
- Удалить *.pyc и __pycache__ файлы
- Выгрузить объект в JSON в Unicode в Python
- Конвертировать datetime в другую часовую зону в Python
- Дополнить строку нулями в Python
- Вычислить MD5 от строки в Python
- Удалить знаки пунктуации из строки в Python
- Проверить, что первая буква в строке — заглавная, в Python
- Разбить (split) строку по нескольким разделителям в Python
- Отсортировать версии в Python
- Распаковать любой архив в Python
- Получить имя текущего скрипта на Python
- Установка pip на Python 2.6
- Отличить печатаемый символ Unicode от непечатаемого на Python
- Вывести версию интерпретатора Python в машиночитаемом виде
- Найти место, куда Python устанавливает пакеты (dist-packages, site-packages)
Профилирование программ
Профилирование позволяет оценить время, затрачиваемое на выполнение отдельных операций в программе. Профилирование можно выполнять как для всего кода, так и для его фрагментов.

Для начала рассмотрим профилирование фрагментов кода.
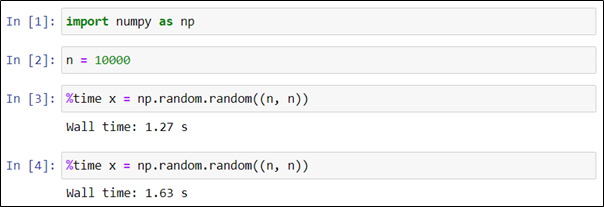
В случае работы в Jupyter notebook можно использовать так называемые “магические команды”. Для того, чтобы узнать время выполнения одной строки, нужно в её начале разместить магическую команду %time. В приведенном ниже примере в последней ячейке тетрадки создается матрица размером 10000×10000, заполненная случайными вещественными числами

Как видно, на это потребовалось 1,27 секунды. Отметим, что повторный запуск аналогичной команды потребовал уже 1,63 секунды.
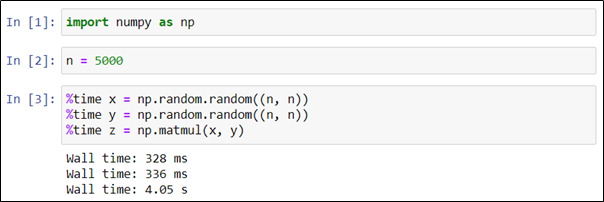
Чтобы оценить время выполнения кода в каждой из строк какой-либо ячейки, необходимо использовать магическую команду %time в каждой строке. В приведенном ниже примере создаются и перемножаются две матрицы размером 5000×5000, заполненные случайными вещественными числами.
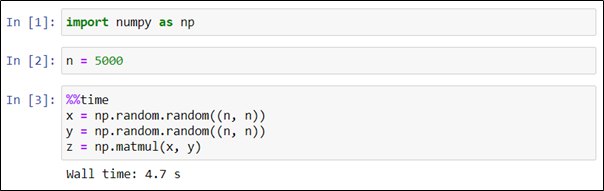
Если же нужно оценить время выполнения ячейки в целом, необходимо использовать команду %%time. Генерация двух матриц и их перемножение потребовали в сумме 4,7 секунды.
Описанные приемы позволяют получить лишь начальное представление о быстродействии кода. Как известно, единичного эксперимента недостаточно для того, чтобы составить адекватное представление о поведении исследуемой системы. Проведем серию экспериментов и возьмем среднее значение в качестве оценки времени выполнения кода. Для этого будем использовать команду %%timeit с ключом -r, задающим количество вычислительных экспериментов.
В следующем примере мы так же генерируем и перемножаем две матрицы в серии из пяти экспериментов.
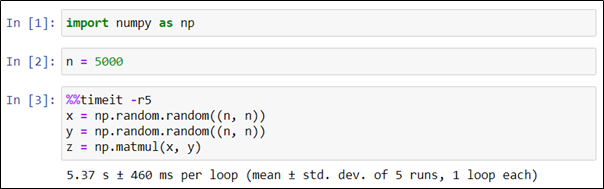
Как видно, среднее значение времени в серии экспериментов (5,37 секунды) отличается от времени единичного эксперимента, проведенного ранее (4,7 секунды).
Рассмотрим еще один пример профилирования кода.
В некоторых случаях имеет смысл сравнить несколько возможных вариантов реализации кода, чтобы выбрать из них наиболее производительный.
Известно, что значение функции “синус” для значений аргумента, близких к нулю, можно представить в виде суммы ряда Маклорена, а приближенное значение вычислить как сумму его первых двух слагаемых.

Исследуем два способа вычисления приближенного значения синуса, отличающихся способом вычисления второго слагаемого: в одном случае через трехкратное перемножение аргумента, в другом — через операцию возведения в степень. Для измерения времени снова воспользуемся командой timeit.
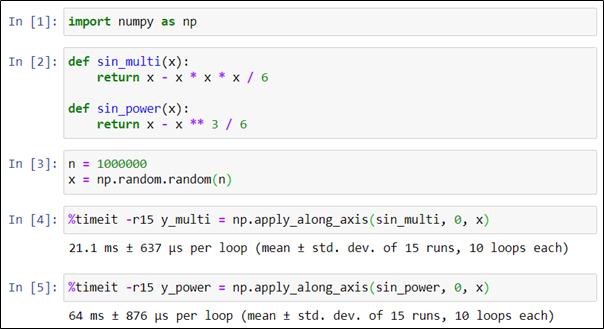
Несмотря на то, что математически эти варианты полностью эквивалентны, вариант с расчетом через перемножение аргументов приблизительно в три раза быстрее варианта с возведением в степень. Этот результат был бы совершенно не очевиден без профилирования.
Перейдем к профилированию кода программы в целом.
Представим, что есть программа min_distance_naive.py, вычисляющая наименьшее расстояние между точками на плоскости и началом координат. Координаты точек представлены матрицей размерности 1000000×2, записанной в файле points.npy. Ключевой фрагмент кода — функция min_dist_naive.
import numpy as np def min_dist_naive(points, base): r_min = float('inf') for p in points: r = ((p[0] - base[0]) ** 2 + (p[1] - base[1]) ** 2) ** (1 / 2) r_min = min(r, r_min) return r_min points = np.load('points.npy') origin = (0, 0) min_dist = min_dist_naive(points, origin) print(min_dist)Для запуска этой программы необходимо в командной строке выполнить следующую команду:
python min_distance_naive.pyДля запуска профилирования дополним эту команду ключом -m cProfile указывающим, что для профилирования нужно использовать модуль cPython, и ключом -s time, указывающим, что результаты профилирования нужно упорядочить по времени.
python -m cPython -s time min_distance_naive.py > naive.txtВесь вывод, в том числе результаты профилирования, будут записаны в текстовый файл naive.txt. Анализ этого файла показывает, что время выполнения программы составило 4,369 с., суммарное время выполнения функции поиска минимального расстояния составило 4,132 с.

Теперь попробуем ускорить выполнение кода. Поскольку алгоритм решения задачи построен вокруг сравнения между собой большого количества расстояний, то, принимая во внимание монотонность функции извлечения квадратного корня, можно исключить эту функцию и сравнивать между собой квадраты расстояний. В соответствии с этой идеей несколько доработаем исходную функцию, исключив из цикла операцию извлечения квадратного корня.
import numpy as np def min_dist_optim(points, base): r_min = float('inf') for p in points: r = (p[0] - base[0]) ** 2 + (p[1] - base[1]) ** 2 r_min = min(r, r_min) r_min = r_min ** (1 / 2) return r_min points = np.load('points.npy') origin = (0, 0) min_dist = min_dist_optim(points, origin) print(min_dist)Запустим профилирование доработанной программы.
python -m cPython -s time min_distance_optimized.py > optimized.txtОбратимся к результатам профилирования.

В этом случае время выполнения функции составило 3,772 с.
По результатам многократного профилирования обоих вариантов и статистической обработки полученных экспериментальных данных, включающей в том числе сравнение выборок с помощью t-критерия Уэлча, получен статистически значимый результат, свидетельствующий о том, что модифицированная функция приблизительно на 8% быстрее исходной. Таким образом, профилирование помогает выявить узкие места в коде с точки зрения производительности, сравнить разные варианты реализации алгоритмов, и в конечном счете ускорить выполнение программ. Код приведенных примеров, а также экспериментальные данные можно найти в репозитории.
- профилирование
- программ
- Python
- Программирование
- Машинное обучение