Связывание таблиц в Postgresql
Помогите разобраться в связывании таблиц в Postgresql (один ко многим). Есть несколько помещений, в каждом из которых установлен электросчетчик. Необходимо таблицу с помещениями связать с таблицей, где находятся переданные показания всех счетчиков (передаются ежемесячно на протяжении длительного времени). Связывыю внешним ключом meter из таблицы places с полем meter_number в таблице meters . а) таблица с помещениями:
CREATE TABLE places ( id integer PRIMARY KEY, name text, meter integer NOT NULL ); б) таблица с показаниями счетчиков:
CREATE TABLE meters ( id integer PRIMARY KEY, meter_number integer NOT NULL, data integer NOT NULL, UNIQUE (id, meter_number) ); Внешний ключ будет ссылаться на поле meter_number , но это поле не уникально (т.к. в таблице meters показания по каждому счётчику за большой интервал времени), поэтому делаю уникальность для группы столбцов ( id и meter_number ). в) делаю связь между таблицами:
ALTER TABLE places ADD CONSTRAINT meters FOREIGN KEY (meter) REFERENCES meters (meter_number) ON UPDATE CASCADE ON DELETE CASCADE; Получаю ошибку: «ERROR: there is no unique constraint matching given keys for referenced table «meters» SQL-состояние: 42830» Подскажите, что делаю не так? Может вообще нужно было делать таблицу с показаниями счётчиков в другом виде (один счётчик – одна таблица)? Но вроде и так должно работать, просто у меня пока не получается.
- postgresql
- связывание-данных
Как связать таблицы в postgresql
Вспомните таблицы weather и cities из Главы 2. Давайте рассмотрим следующую задачу: вы хотите добиться, чтобы никто не мог вставить в таблицу weather строки, для которых не находится соответствующая строка в таблице cities . Это называется обеспечением ссылочной целостности данных. В простых СУБД это пришлось бы реализовать (если это вообще возможно) так: сначала явно проверить, есть ли соответствующие записи в таблице cities , а затем отклонить или вставить новые записи в таблицу weather . Этот подход очень проблематичен и неудобен, поэтому всё это Postgres Pro может сделать за вас.
Новое объявление таблицы будет выглядеть так:
CREATE TABLE cities ( name varchar(80) primary key, location point ); CREATE TABLE weather ( city varchar(80) references cities(name), temp_lo int, temp_hi int, prcp real, date date );
Теперь попробуйте вставить недопустимую запись:
INSERT INTO weather VALUES ('Berkeley', 45, 53, 0.0, '1994-11-28');
ОШИБКА: INSERT или UPDATE в таблице "weather" нарушает ограничение внешнего ключа "weather_city_fkey" ПОДРОБНОСТИ: Ключ (city)=(Berkeley) отсутствует в таблице "cities".
Поведение внешних ключей можно подстроить согласно требованиям вашего приложения. Мы не будем усложнять этот простой пример в данном введении, но вы можете обратиться за дополнительной информацией к Главе 5. Правильно применяя внешние ключи, вы определённо создадите более качественные приложения, поэтому мы настоятельно рекомендуем изучить их.
| Пред. | Наверх | След. |
| 3.2. Представления | Начало | 3.4. Транзакции |
Как связать таблицы в postgresql

Начнем с создания таблицы классов ( classrooms ). Таблица будет простой: она будет содержать идентификатор id и имя учителя – teacher. Напишите следующий код в окне запроса ( query tool ) и запустите ( run или F5 ).
DROP TABLE IF EXISTS classrooms CASCADE; CREATE TABLE classrooms ( id INT PRIMARY KEY GENERATED ALWAYS AS IDENTITY, teacher VARCHAR(100) ); В первой строке фрагмент DROP TABLE IF EXISTS classrooms удалит таблицу classrooms , если она уже существует. Важно учитывать, что Postgres, не позволит нам удалить таблицу, если она имеет связи с другими таблицами, поэтому, чтобы обойти это ограничение ( constraint ) в конце строки добавлен оператор CASCADE . CASCADE – автоматически удалит или изменит строки из зависимой таблицы, при внесении изменений в главную. В нашем случае нет ничего страшного в удалении таблицы, поскольку, если мы на это пошли, значит мы будем пересоздавать всё с нуля, и остальные таблицы тоже удалятся.
Добавление DROP TABLE IF EXISTS перед CREATE TABLE позволит нам систематизировать схему нашей базы данных и создать скрипты, которые будут очень удобны, если мы захотим внести изменения – например, добавить таблицу, изменить тип данных поля и т. д. Для этого нам просто нужно будет внести изменения в уже готовый скрипт и перезапустить его.
Ничего нам не мешает добавить наш код в систему контроля версий . Весь код для создания базы данных из этой статьи вы можете посмотреть по ссылке .
Также вы могли обратить внимание на четвертую строчку. Здесь мы определили, что колонка id является первичным ключом ( primary key ), что означает следующее: в каждой записи в таблице это поле должно быть заполнено и каждое значение должно быть уникальным. Чтобы не пришлось постоянно держать в голове, какое значение id уже было использовано, а какое – нет, мы написали GENERATED ALWAYS AS IDENTITY , этот приём является альтернативой синтаксису последовательности ( CREATE SEQUENCE ). В результате при добавлении записей в эту таблицу нам нужно будет просто добавить имя учителя.
И в пятой строке мы определили, что поле teacher имеет тип данных VARCHAR (строка) с максимальной длиной 100 символов. Если в будущем нам понадобится добавить в таблицу учителя с более длинным именем, нам придется либо использовать инициалы, либо изменять таблицу ( alter table ).
Теперь давайте создадим таблицу учеников ( students ). Новая таблица будет содержать: уникальный идентификатор ( id ), имя ученика ( name ), и внешний ключ ( foreign key ), который будет указывать ( references ) на таблицу классов.
DROP TABLE IF EXISTS students CASCADE; CREATE TABLE students ( id INT PRIMARY KEY GENERATED ALWAYS AS IDENTITY, name VARCHAR(100), classroom_id INT, CONSTRAINT fk_classrooms FOREIGN KEY(classroom_id) REFERENCES classrooms(id) ); И снова мы перед созданием новой таблицы удаляем старую, если она существует, добавляем поле id , которое автоматически увеличивает своё значение и имя с типом данных VARCHAR (строка) и максимальной длиной 100 символов. Также в эту таблицу мы добавили колонку с идентификатором класса ( classroom_id ), и с седьмой по девятую строку установили, что ее значение указывает на колонку id в таблице классов ( classrooms ).
Мы определили, что classroom_id является внешним ключом. Это означает, что мы задали правила, по которым данные будут записываться в таблицу учеников ( students ). То есть Postgres на данном этапе не позволит нам вставить строку с данными в таблицу учеников ( students ), в которой указан идентификатор класса ( classroom_id ), не существующий в таблице classrooms . Например: у нас в таблице классов 10 записей ( id с 1 до 10), система не даст нам вставить данные в таблицу учеников, у которых указан идентификатор класса 11 и больше.
Невозможно вставить данные, поскольку в таблице классов нет записи с >
INSERT INTO students (name, classroom_id) VALUES ('Matt', 1); /* ERROR: insert or update on table "students" violates foreign key constraint "fk_classrooms" DETAIL: Key (classroom_id)=(1) is not present in table "classrooms". SQL state: 23503 */ Теперь давайте добавим немного данных в таблицу классов ( classrooms ). Так как мы определили, что значение в поле id будет увеличиваться автоматически, нам нужно только добавить имена учителей.
INSERT INTO classrooms (teacher) VALUES ('Mary'), ('Jonah'); SELECT * FROM classrooms; /* id | teacher -- | ------- 1 | Mary 2 | Jonah */ Прекрасно! Теперь у нас есть записи в таблице классов, и мы можем добавить данные в таблицу учеников, а также установить нужные связи (с таблицей классов).
INSERT INTO students (name, classroom_id) VALUES ('Adam', 1), ('Betty', 1), ('Caroline', 2); SELECT * FROM students; /* id | name | classroom_id -- | -------- | ------------ 1 | Adam | 1 2 | Betty | 1 3 | Caroline | 2 */ Но что же случится, если у нас появится новый ученик, которому ещё не назначили класс? Неужели нам придется ждать, пока станет известно в каком он классе, и только после этого добавить его запись в базу данных?
Конечно же, нет. Мы установили внешний ключ, и он будет блокировать запись, поскольку ссылка на несуществующий id класса невозможна, но мы можем в качестве идентификатора класса ( classroom_id ) передать null . Это можно сделать двумя способами: указанием null при записи значений, либо просто передачей только имени.
-- явно определим значение NULL INSERT INTO students (name, classroom_id) VALUES ('Dina', NULL); -- неявно определим значение NULL INSERT INTO students (name) VALUES ('Evan'); SELECT * FROM students; /* id | name | classroom_id -- | -------- | ------------ 1 | Adam | 1 2 | Betty | 1 3 | Caroline | 2 4 | Dina | [null] 5 | Evan | [null] */ И наконец, давайте заполним таблицу успеваемости. Этот параметр, как правило, формируется из нескольких составляющих – домашние задания, участие в проектах, посещаемость и экзамены. Мы будем использовать две таблицы. Таблица заданий ( assignments ), как понятно из названия, будет содержать данные о самих заданиях, и таблица оценок ( grades ), в которой мы будем хранить данные о том, как ученик выполнил эти задания.
DROP TABLE IF EXISTS assignments CASCADE; DROP TABLE IF EXISTS grades CASCADE; CREATE TABLE assignments ( id INT PRIMARY KEY GENERATED ALWAYS AS IDENTITY, category VARCHAR(20), name VARCHAR(200), due_date DATE, weight FLOAT ); CREATE TABLE grades ( id INT PRIMARY KEY GENERATED ALWAYS AS IDENTITY, assignment_id INT, score INT, student_id INT, CONSTRAINT fk_assignments FOREIGN KEY(assignment_id) REFERENCES assignments(id), CONSTRAINT fk_students FOREIGN KEY(student_id) REFERENCES students(id) ); Вместо того чтобы вставлять данные вручную, давайте загрузим их с помощью CSV-файла. Вы можете скачать файл из этого репозитория или создать его самостоятельно. Имейте в виду, чтобы разрешить pgAdmin доступ к данным, вам может понадобиться расширить права доступа к папке (в моем случае – это папка db_data ).
COPY assignments(category, name, due_date, weight) FROM 'C:/Users/mgsosna/Desktop/db_data/assignments.csv' DELIMITER ',' CSV HEADER; /* COPY 5 Query returned successfully in 118 msec. */ COPY grades(assignment_id, score, student_id) FROM 'C:/Users/mgsosna/Desktop/db_data/grades.csv' DELIMITER ',' CSV HEADER; /* COPY 25 Query returned successfully in 64 msec. */ Теперь давайте проверим, что мы всё сделали верно. Напишем запрос, который покажет среднюю оценку, по каждому виду заданий с группировкой по учителям.
SELECT c.teacher, a.category, ROUND(AVG(g.score), 1) AS avg_score FROM students AS s INNER JOIN classrooms AS c ON c.id = s.classroom_id INNER JOIN grades AS g ON s.id = g.student_id INNER JOIN assignments AS a ON a.id = g.assignment_id GROUP BY 1, 2 ORDER BY 3 DESC; /* teacher | category | avg_score ------- | --------- | --------- Jonah | project | 100.0 Jonah | homework | 94.0 Jonah | exam | 92.5 Mary | homework | 78.3 Mary | exam | 76.0 Mary | project | 69.5 */ Отлично! Мы установили, настроили и наполнили базу данных.
Итак, в этой статье мы научились:
- создавать базу данных;
- создавать таблицы;
- наполнять таблицы данными;
- устанавливать связи между таблицами;
Теперь у нас всё готово, чтобы пробовать более сложные возможности SQL. Мы начнем с возможностей синтаксиса, которые, вероятно, вам еще не знакомы и которые откроют перед вами новые границы в написании SQL-запросов. Также мы разберем некоторый виды соединений таблиц ( JOIN ) и способы организации запросов в тех случаях, когда они занимают десятки или даже сотни строк.
В следующей части мы разберем:
- виды фильтраций в запросах;
- запросы с условиями типа if-else;
- новые виды соединений таблиц;
- функции для работы с массивами;
Материалы по теме
- �� 8 лучших GUI клиентов PostgreSQL в 2021 году
- ���� Python и MySQL: практическое введение
- ����️ Управление данными с помощью Python, SQLite и SQLAlchemy
Связи между таблицами базы данных
Связи — это довольна важная тема, которую следует понимать при проектировании баз данных. По своему личному опыту скажу, что осознав связи, мне намного легче далось понимание нормализации базы данных.
1.1. Для кого эта статья?
Эта статья будет полезна тем, кто хочет разобраться со связями между таблицами базы данных. В ней я постарался рассказать на понятном языке, что это такое. Для лучшего понимания темы, я чередую теоретический материал с практическими примерами, представленными в виде диаграммы и запроса, создающего нужные нам таблицы. Я использую СУБД Microsoft SQL Server и запросы пишу на T-SQL. Написанный мною код должен работать и на других СУБД, поскольку запросы являются универсальными и не используют специфических конструкций языка T-SQL.
1.2. Как вы можете применить эти знания?
- Процесс создания баз данных станет для вас легче и понятнее.
- Понимание связей между таблицами поможет вам легче освоить нормализацию, что является очень важным при проектировании базы данных.
- Разобраться с чужой базой данных будет значительно проще.
- На собеседовании это будет очень хорошим плюсом.
2. Благодарности
Учтены были советы и критика авторов jobgemws, unfilled, firnind, Hamaruba.
Спасибо!
3.1. Как организовываются связи?
Связи создаются с помощью внешних ключей (foreign key).
Внешний ключ — это атрибут или набор атрибутов, которые ссылаются на primary key или unique другой таблицы. Другими словами, это что-то вроде указателя на строку другой таблицы.
3.2. Виды связей
Связи делятся на:
- Многие ко многим.
- Один ко многим.
- с обязательной связью;
- с необязательной связью;
- Один к одному.
- с обязательной связью;
- с необязательной связью;
4. Многие ко многим
Представим, что нам нужно написать БД, которая будет хранить работником IT-компании. При этом существует некий стандартный набор должностей. При этом:
- Работник может иметь одну и более должностей. Например, некий работник может быть и админом, и программистом.
- Должность может «владеть» одним и более работников. Например, админами является определенный набор работников. Другими словами, к админам относятся некие работники.
4.1. Как построить такие таблицы?
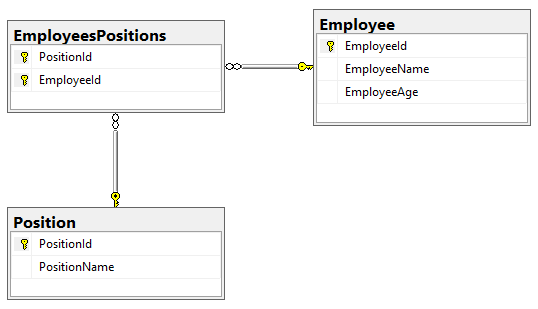
Мы уже имеем две таблицы, описывающие работника и профессию. Теперь нам нужно установить между ними связь многие ко многим. Для реализации такой связи нам нужен некий посредник между таблицами «Employee» и «Position». В нашем случае это будет некая таблица «EmployeesPositions» (работники и должности). Эта таблица-посредник связывает между собой работника и должность следующим образом:
| EmployeeId | PositionId |
|---|---|
| 1 | 1 |
| 1 | 2 |
| 2 | 3 |
| 3 | 3 |
Слева указаны работники (их id), справа — должности (их id). Работники и должности на этой таблице указываются с помощью id’шников.
На эту таблицу можно посмотреть с двух сторон:
- Таким образом, мы говорим, что работник с id 1 находится на должность с id 1. При этом обратите внимание на то, что в этой таблице работник с id 1 имеет две должности: 1 и 2. Т.е., каждому работнику слева соответствует некая должность справа.
- Мы также можем сказать, что должности с id 3 принадлежат пользователи с id 2 и 3. Т.е., каждой роли справа принадлежит некий работник слева.
4.2. Реализация
Диаграмма
Код на T-SQL
create table dbo.Employee ( EmployeeId int primary key, EmployeeName nvarchar(128) not null, EmployeeAge int not null ) -- Заполним таблицу Employee данными. insert into dbo.Employee(EmployeeId, EmployeeName, EmployeeAge) values (1, N'John Smith', 22) insert into dbo.Employee(EmployeeId, EmployeeName, EmployeeAge) values (2, N'Hilary White', 22) insert into dbo.Employee(EmployeeId, EmployeeName, EmployeeAge) values (3, N'Emily Brown', 22) create table dbo.Position ( PositionId int primary key, PositionName nvarchar(64) not null ) -- Заполним таблицу Position данными. insert into dbo.Position(PositionId, PositionName) values(1, N'IT-director') insert into dbo.Position(PositionId, PositionName) values(2, N'Programmer') insert into dbo.Position(PositionId, PositionName) values(3, N'Engineer') -- Заполним таблицу EmployeesPositions данными. create table dbo.EmployeesPositions ( PositionId int foreign key references dbo.Position(PositionId), EmployeeId int foreign key references dbo.Employee(EmployeeId), primary key(PositionId, EmployeeId) ) insert into dbo.EmployeesPositions(EmployeeId, PositionId) values (1, 1) insert into dbo.EmployeesPositions(EmployeeId, PositionId) values (1, 2) insert into dbo.EmployeesPositions(EmployeeId, PositionId) values (2, 3) insert into dbo.EmployeesPositions(EmployeeId, PositionId) values (3, 3)Объяснения
С помощью ограничения foreign key мы можем ссылаться на primary key или unique другой таблицы. В этом примере мы
- ссылаемся атрибутом PositionId таблицы EmployeesPositions на атрибут PositionId таблицы Position;
- атрибутом EmployeeId таблицы EmployeesPositions — на атрибут EmployeeId таблицы Employee;
4.3. Вывод
Для реализации связи многие ко многим нам нужен некий посредник между двумя рассматриваемыми таблицами. Он должен хранить два внешних ключа, первый из которых ссылается на первую таблицу, а второй — на вторую.
5. Один ко многим
Эта самая распространенная связь между базами данных. Мы рассматриваем ее после связи многие ко многим для сравнения.
Предположим, нам нужно реализовать некую БД, которая ведет учет данных о пользователях. У пользователя есть: имя, фамилия, возраст, номера телефонов. При этом у каждого пользователя может быть от одного и больше номеров телефонов (многие номера телефонов).
В этом случае мы наблюдаем следующее: пользователь может иметь многие номера телефонов, но нельзя сказать, что номеру телефона принадлежит определенный пользователь.
Другими словами, телефон принадлежит только одному пользователю. А пользователю могут принадлежать 1 и более телефонов (многие).
Как мы видим, это отношение один ко многим.
5.1. Как построить такие таблицы?
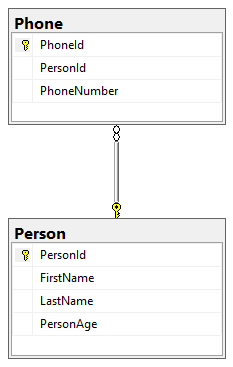
Пользователей будет представлять некая таблица «Person» (id, имя, фамилия, возраст), номера телефонов будет представлять таблица «Phone». Она будет выглядеть так:
| PhoneId | PersonId | PhoneNumber |
|---|---|---|
| 1 | 5 | 11 091-10 |
| 2 | 5 | 19 124-66 |
| 3 | 17 | 21 972-02 |
Данная таблица представляет три номера телефона. При этом номера телефона с id 1 и 2 принадлежат пользователю с id 5. А вот номер с id 3 принадлежит пользователю с id 17.
Заметка. Если бы у таблицы «Phones» было бы больше атрибутов, то мы смело бы их добавляли в эту таблицу.
5.2. Почему мы не делаем тут таблицу-посредника?
Таблица-посредник нужна только в том случае, если мы имеем связь многие-ко-многим. По той простой причине, что мы можем рассматривать ее с двух сторон. Как, например, таблицу EmployeesPositions ранее:
- Каждому работнику принадлежат несколько должностей (многие).
- Каждой должности принадлежит несколько работников (многие).
5.3. Реализация
Диаграмма
Код на T-SQL
create table dbo.Person ( PersonId int primary key, FirstName nvarchar(64) not null, LastName nvarchar(64) not null, PersonAge int not null ) insert into dbo.Person(PersonId, FirstName, LastName, PersonAge) values (5, N'John', N'Doe', 25) insert into dbo.Person(PersonId, FirstName, LastName, PersonAge) values (17, N'Izabella', N'MacMillan', 19) create table dbo.Phone ( PhoneId int primary key, PersonId int foreign key references dbo.Person(PersonId), PhoneNumber varchar(64) not null ) insert into dbo.Phone(PhoneId, PersonId, PhoneNumber) values (1, 5, '11 091-10') insert into dbo.Phone(PhoneId, PersonId, PhoneNumber) values (2, 5, '19 124-66') insert into dbo.Phone(PhoneId, PersonId, PhoneNumber) values (3, 17, '21 972-02') Объяснения
Наша таблица Phone хранит всего один внешний ключ. Он ссылается на некого пользователя (на строку из таблицы Person). Таким образом, мы как бы говорим: «этот пользователь является владельцем данного телефона». Другими словами, телефон знает id своего владельца.
6. Один к одному
Представим, что на работе вам дали задание написать БД для учета всех работников для HR. Начальник уверял, что компании нужно знать только об имени, возрасте и телефоне работника. Вы разработали такую БД и поместили в нее всю 1000 работников компании. И тут начальник говорит, что им зачем-то нужно знать о том, является ли работник инвалидом или нет. Наиболее простое, что приходит в голову — это добавить новый столбец типа bool в вашу таблицу. Но это слишком долго вписывать 1000 значений и ведь true вы будете вписывать намного реже, чем false (2% будут true, например).
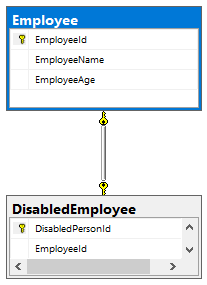
Более простым решением будет создать новую таблицу, назовем ее «DisabledEmployee». Она будет выглядеть так:
| DisabledPersonId | EmployeeId |
|---|---|
| 1 | 159 |
| 2 | 722 |
| 3 | 937 |
Но это еще не связь один к одному. Дело в том, что в такую таблицу работник может быть вписан более одного раза, соответственно, мы получили отношение один ко многим: работник может быть несколько раз инвалидом. Нужно сделать так, чтобы работник мог быть вписан в таблицу только один раз, соответственно, мог быть инвалидом только один раз. Для этого нам нужно указать, что столбец EmployeeId может хранить только уникальные значения. Нам нужно просто наложить на столбец EmloyeeId ограничение unique. Это ограничение сообщает, что атрибут может принимать только уникальные значения.
Выполнив это мы получили связь один к одному.
Заметка. Обратите внимание на то, что мы могли также наложить на атрибут EmloyeeId ограничение primary key. Оно отличается от ограничения unique лишь тем, что не может принимать значения null.
6.1. Вывод
Можно сказать, что отношение один к одному — это разделение одной и той же таблицы на две.
6.2. Реализация
Диаграмма
Код на T-SQL
create table dbo.Employee ( EmployeeId int primary key, EmployeeName nvarchar(128) not null, EmployeeAge int not null ) insert into dbo.Employee(EmployeeId, EmployeeName, EmployeeAge) values (159, N'John Smith', 22) insert into dbo.Employee(EmployeeId, EmployeeName, EmployeeAge) values (722, N'Hilary White', 29) insert into dbo.Employee(EmployeeId, EmployeeName, EmployeeAge) values (937, N'Emily Brown', 19) insert into dbo.Employee(EmployeeId, EmployeeName, EmployeeAge) values (100, N'Frederic Miller', 16) insert into dbo.Employee(EmployeeId, EmployeeName, EmployeeAge) values (99, N'Henry Lorens', 20) insert into dbo.Employee(EmployeeId, EmployeeName, EmployeeAge) values (189, N'Bob Red', 25) create table dbo.DisabledEmployee ( DisabledPersonId int primary key, EmployeeId int unique foreign key references dbo.Employee(EmployeeId) ) insert into dbo.DisabledEmployee(DisabledPersonId, EmployeeId) values (1, 159) insert into dbo.DisabledEmployee(DisabledPersonId, EmployeeId) values (2, 722) insert into dbo.DisabledEmployee(DisabledPersonId, EmployeeId) values (3, 937)Объяснения
Таблица DisabledEmployee имеет атрибут EmployeeId, что является внешним ключом. Он ссылается на атрибут EmployeeId таблицы Employee. Кроме того, этот атрибут имеет ограничение unique, что говорит о том, что в него могут быть записаны только уникальные значения. Соответственно, работник может быть записан в эту таблицу не более одного раза.
7. Обязательные и необязательные связи
Связи можно поделить на обязательные и необязательные.
7.1. Один ко многим
- Один ко многим с обязательной связью:
К одному полку относятся многие бойцы. Один боец относится только к одному полку. Обратите внимание, что любой солдат обязательно принадлежит к одному полку, а полк не может существовать без солдат. - Один ко многим с необязательной связью:
На планете Земля живут все люди. Каждый человек живет только на Земле. При этом планета может существовать и без человечества. Соответственно, нахождение нас на Земле не является обязательным
У одной биологической матери может быть много детей. У ребенка есть только одна биологическая мать.
А) У женщины необязательно есть свои дети. Соответственно, связь необязательна.
Б) У ребенка обязательно есть только одна биологическая мать – в таком случае, связь обязательна.
7.2. Один к одному
- Один к одному с обязательной связью:
У одного гражданина определенной страны обязательно есть только один паспорт этой страны. У одного паспорта есть только один владелец. - Один к одному с необязательной связью:
У одной страны может быть только одна конституция. Одна конституция принадлежит только одной стране. Но конституция не является обязательной. У страны она может быть, а может и не быть, как, например, у Израиля и Великобритании.
У одного человека может быть только один загранпаспорт. У одного загранпаспорта есть только один владелец.
А) Наличие загранпаспорта необязательно – его может и не быть у гражданина. Это необязательная связь.
Б) У загранпаспорта обязательно есть только один владелец. В этом случае, это уже обязательная связь.
7.3. Многие ко многим
Любая связь многие ко многим является необязательной. Например:
Человек может инвестировать в акции разных компаний (многих). Инвесторами какой-то компании являются определенные люди (многие).
А) Человек может вообще не инвестировать свои деньги в акции.
Б) Акции компании мог никто не купить.
8. Как читать диаграммы?
Выше я приводил диаграммы созданных нами таблиц. Но для того, чтобы их понимать, нужно знать, как их «читать». Разберемся в этом на примере диаграммы из пункта 5.3.
Мы видим отношение один ко многим. Одной персоне принадлежит много телефонов.
- Возле таблицы Person находится золотой ключик. Он обозначает слово «один».
- Возле таблицы Phone находится знак бесконечности. Он обозначает слово «многие».
9. Итоги
- Связи бывают:
- Многие ко многим.
- Один ко многим.
1) с обязательной связью;
2) с необязательной связью. - Один к одному.
1) с обязательной связью;
2) с необязательной связью.
- Связи организовываются с помощью внешних ключей.
- Foreign key (внешний ключ) — это атрибут или набор атрибутов, которые ссылаются на primary key или unique другой таблицы. Другими словами, это что-то вроде указателя на строку другой таблицы.
10. Задачи
Для лучшего усвоения материала предлагаю вам решить следующие задачи:
- Описать таблицу фильм: id, название, длительность, режиссер, жанр фильма. Обратите внимание на то, что у фильма может быть более одного жанра, а к одному жанру может относится более, чем один фильм.
- Описать таблицу песня: id, название, длительность, певец. При этом у песни может быть более одного певца, а певец мог записать более одной песни.
- Реализовать таблицу машина: модель, производитель, цвет, цена
- Описать отдельную таблицу производитель: id, название, рейтинг.
- Описать отдельную таблицу цвета: id, название.
У одной машины может быть только один производитель, а у производителя — много машин. У одной машины может быть много цветов, а у одного цвета может быть много машин.
- Добавить в БД из пункта 6.2. таблицу военно-обязанных по типу того, как мы описали отдельную таблицу DisabledEmployee.
- SQL
- Microsoft SQL Server