Как правильно произвести выборку из подзапроса
В командах выборки могут использоваться вложенные команды выборки, или подзапросы. При использовании подзапросов, при выборке данных из каждого следующей записи в основной команде выборки, в общем случае производится выборка по всем записям выборки подзапроса. В том случае если результаты выполнения подзапроса для всех записей основной выборки являются одинаковыми, подзапрос выполняется однократно и его результаты используются при выполнении основной выборки для всех записей.
В подзапросах могут использоваться значения полей, получаемые в основной выборке, причем если в основной выборке и в подзапросе запрашиваются данные из одного и того же слоя, то для него должны быть заданы псевдонимы, отличающиеся для основной выборки и подзапроса, и обращение к полям следует выполнять используя псевдоним названия слоя.
Подзапросы использующие данные из полей основной выборки значительно замедляют выполнение команды выборки, поскольку такие подзапросы выполняются для каждой записи в основной выборке. Поэтому рекомендуется по возможности заменять их использование другими средствами языка SQL.
Возможны три основные варианты использования подзапросов:
- Результатом выполнения подзапроса является единственное значение. Это возможно, например, если в подзапросе вычисляется значение агрегирующей функции по всем записям выборки. Такие подзапросы могут использоваться в составе выражений в командах выборки, наряду с обычными значениями и функциями. Использование подзапроса возвращающего единственное значение
SELECT b.sys, b.Geometry.STArea(), k.sys FROM Здания AS b, Кварталы AS k WHERE b.Geometry.Within(k.Geometry) AND b.Geometry.STArea()/ (SELECT SUM(b2.Geometry.STArea()) FROM Здания AS b2 WHERE b2.Geometry.STWithin(k.Geometry)) > 0.1
- конструкция b.Geometry.STArea() возвращает площадь объекта слоя с псевдонимом b ;
- для слоя Здания задается псевдоним b . По этому псевдониму можно обращаться к полям записи запрашиваемой в основной команде выборки;
- конструкция b.Geometry.Within(k.Geometry) проверяет, располагается ли здание внутри квартала;
- результатом выполнения вложенного запроса является суммарная площадь зданий в квартале в который входит искомое здание;
- в подзапросе происходит обращение к объекту слоя Кварталы из основной выборки.
Приведенный запрос находит объекты слоя Здания (или просто здания) располагающиеся внутри объектов слоя Кварталы (кварталов), находится общая площадь зданий в данном квартале и выводятся информация о записях площадь которых больше 10% от общей площади зданий в данном квартале.
Вывод результата подзапроса
SELECT b.sys, b.Geometry.STArea()/( SELECT SUM(b2.Geometry.STArea()) FROM Здания AS b2 WHERE b2.Geometry.STIntersects(k.Geometry)), k.sys FROM Здания AS b, Кварталы AS k WHERE b.Geometry.intersects(k.Geometry) AND b.Geometry.STArea()/( SELECT SUM(b2.Geometry.STArea()) FROM Здания AS b2 WHERE b2.Geometry.STIntersects(k.Geometry)) > 0.1
Приведенный запрос аналогичен рассмотренному в предыдущем примере, за тем исключением, в результате выполнения команды выборки выводятся не площади объектов, а их отношение к общей площади объектов в квартале.
SELECT sys, Улица FROM Здания WHERE Улица IN ( SELECT Улица from Здания GROUP BY Улица HAVING COUNT(*)>20 )
SELECT sys FROM Кварталы AS k WHERE EXISTS( SELECT * FROM Здания AS b where b.Geometry.Intersects(k.Geometry) AND b.perimeter < k.perimeter /13 )
Как правильно произвести выборку из подзапроса
В выражении SELECT мы можем вводить подзапросы четырьмя способами:
- В условии в выражении WHERE
- В условии в выражении HAVING
- В качестве таблицы для выборки в выражении FROM
- В качестве спецификации столбца в выражении SELECT
Рассмотрим некоторые из этих случаев. Например, получим все товары, у которых цена выше средней:
SELECT * FROM Products WHERE Price > (SELECT AVG(Price) FROM Products)
Чтобы получить нужные товары, нам вначале надо выполнить подзапрос на получение средней цены товара: SELECT AVG(Price) FROM Products .
Оператор IN
Нередко подзапросы применяются вместе с оператором IN , который выбирает из набора значений. И подзапрос как раз может предоставить требуемый набор значений. Например, выберем все товары из таблицы Products, на которые есть заказы в таблице Orders:
SELECT * FROM Products WHERE Id IN (SELECT ProductId FROM Orders)
То есть подзапрос в данном случае выбирает все идентификаторы товаров из Orders, затем по этим идентификаторам извлекаютя товары из Products.
Добавив оператор NOT , мы можем выбрать те товары, на которые нет заказов в таблице Orders:
SELECT * FROM Products WHERE Id NOT IN (SELECT ProductId FROM Orders)
Стоит отметить, что это не самый эффективный способ для извлечения связанных данных из других таблиц, так как для сведения данных из разных таблиц можно использовать оператор JOIN, который рассматривается в следующей главе.
Получение набора значений
При использовании в операторах сравнения подзапросы должны возвращать одно скалярное значение. Но иногда возникает необходимость получить набор значений. Чтобы при использовании в операторах сравнения подзапрос мог возвращать набор значений, перед ним необходимо использовать один из операторов: ALL , SOME или ANY .
При использовании ключевого слова ALL условие в операции сравнения должно быть верно для всех значений, которые возвращаются подзапросом. Например, найдем все товары, цена которых меньше чем у любого товара фирмы Apple:
SELECT * FROM Products WHERE Price < ALL(SELECT Price FROM Products WHERE Manufacturer='Apple')
Если бы мы в данном случае опустили бы ключевое слово ALL, то мы бы столкнулись с ошибкой.
Допустим, если данный подзапрос возвращает значения vаl1, val2 и val3, то условие фильтрации фактически было бы аналогично объединению этих значений через оператор AND:
WHERE Price < val1 AND Price < val2 AND Price < val3
В тоже время подобный запрос гораздо проще переписать другим образом:
SELECT * FROM Products WHERE Price < (SELECT MIN(Price) FROM Products WHERE Manufacturer='Apple')
Как работает оператор ALL:
- x > ALL (1, 2) эквивалентно x > 2
- x < ALL (1, 2) эквивалентно x < 1
- x = ALL (1, 2) эквивалентно (x = 1) AND (x = 2)
- x <> ALL (1, 2) эквивалентно x NOT IN (1, 2)
Операторы ANY и SOME условие в операции сравнения должно быть истинным для хотя бы одного из значений, возвращаемых подзапросом. По своему действию оба этих оператора аналогичны, поэтому можно применять любой из них. Например, в следующем случае получим товары, которые стоят меньше самого дорогого товара компании Apple:
SELECT * FROM Products WHERE Price < ANY(SELECT Price FROM Products WHERE Manufacturer='Apple')
И также стоит отметить, что данный запрос можно сделать проще, переписав следующим образом:
SELECT * FROM Products WHERE Price < (SELECT MAX(Price) FROM Products WHERE Manufacturer='Apple')
Как работает оператор ANY (а также SOME):
- x > ANY (1, 2) эквивалентно x > 1
- x < ANY (1, 2) эквивалентно x < 2
- x = ANY (1, 2) эквивалентно x IN (1, 2)
- x <> ANY (1, 2) эквивалентно (x <> 1) OR (x <> 2)
Подзапрос как спецификация столбца
Результат подзапроса может представлять отдельный столбец в выборке. Например, выберем все заказы и добавим к ним информацию о названии товара:
SELECT *, (SELECT ProductName FROM Products WHERE AS Product FROM Orders

Подзапросы в команде INSERT
В команде INSERT подзапросы могут применяться для определения значения, которое вставляется в один из столбцов:
INSERT INTO Orders (ProductId, CreatedAt, ProductCount, Price) VALUES ( (SELECT Id FROM Products WHERE ProductName='Galaxy S8'), '2018-05-23', 2, (SELECT Price FROM Products WHERE ProductName='Galaxy S8') )
Подзапросы в команде UPDATE
В команде UPDATE подзапросы могут применяться:
- В качестве устанавливаемого значения после оператора SET
- Как часть условия в выражении WHERE
Так, увеличим в таблице Orders количество купленных товаров компании Apple на 2:
UPDATE Orders SET ProductCount = ProductCount + 2 WHERE ProductId IN (SELECT Id FROM Products WHERE Manufacturer='Apple');
Или установим для заказа цену товара, полученную в результате подзапроса:
UPDATE Orders SET Price = (SELECT Price FROM Products WHERE + 3000 WHERE в команде DELETE
В команде DELETE подзапросы также применяются как часть условия. Так, удалим все заказы на Galaxy S8:
DELETE FROM Orders WHERE ProductId=(SELECT Id FROM Products WHERE ProductName='Galaxy S8');
Типичные причины неоптимальной работы запросов и методы оптимизации
В статье приводятся типичные причины неоптимальной работы запросов, диагностируемые на уровне кода конфигурации, и рассматриваются методики оптимизации запросов.
Значительная часть проблем, приводящих к неоптимальной работе запросов, может быть обнаружена путем анализа кода конфигурации и структуры метаданных. Имеется перечень типичных ошибок в коде и структуре данных, последствия которых достаточно хорошо изучены и легко предсказуемы. Анализ кода с использованием этого перечня позволяет решить большую часть проблем с производительностью запросов, не углубляясь в детальную техническую информацию (текст запроса на языке SQL, план запроса и т.д.).
Основные причины неоптимальной работы запросов, диагностируемые на уровне кода конфигурации и структуры метаданных:
- соединения с подзапросами
- соединения с виртуальными таблицами
- несоответствие индексов и условий запроса
- использование логического ИЛИ в условиях
- использование подзапросов в условии соединения
- получение данных через точку от полей составного типа
- фильтрация виртуальных таблиц без использования параметров
В настоящей статье рассматриваются перечисленные причины неоптимальной работы запросов и даются рекомендации по их оптимизации.
Cоединения с подзапросами
Рекомендации
При написании запросов не следует использовать соединения с подзапросами . Следует соединять друг с другом только объекты метаданных или временные таблицы. Если запрос использует соединения с подзапросами, то его следует переписать с использованием временных таблиц .
Если запрос содержит соединения с подзапросами, то это может привести к следующим негативным последствиям:
- Крайне медленное выполнение запроса при слабой загрузке серверного оборудования. Замедление запроса может быть очень значительным (до нескольких порядков).
- Нестабильная работа запроса. При некоторых условиях запрос может работать достаточно быстро, при других - очень медленно.
- Значительная разница по времени выполнения запроса на разных СУБД.
- Повышенная чувствительность запроса к актуальности и полноте статистик. Сразу после полного обновления статистик запрос может работать быстро, но через некоторое время опять замедлиться.
Пример потенциально опасного запроса, использующего соединение с подзапросом:
ВЫБРАТЬ ... ИЗ Документ.РеализацияТоваровУслуг ЛЕВОЕ СОЕДИНЕНИЕ ( ВЫБРАТЬ ИЗ РегистрСведений.Лимиты ГДЕ ... СГРУППИРОВАТЬ ПО ... ) ПО ...
В данном примере в правой части соединения используется подзапрос, а не объект метаданных. Обратите внимание на то, что в какой части соединения (правой или левой) используется подзапрос - не важно. Точно так же не важно, какого типа соединение указано (ЛЕВОЕ, ПРАВОЕ и т.д.). Во всех случаях такая конструкция является потенциально опасной и должна быть исправлена при помощи временных таблиц.
Обратите внимание на то, что возможность использования временных таблиц появилась в 1С:Предприятии начиная с версии 8.1. Если вы используете версию 8.0, то для решения проблемы производительности такого запроса следует перейти на 8.1.
Для оптимизации запроса следует разбить его на несколько отдельных запросов (по числу подзапросов, используемых в соединениях). Эти запросы рекомендуется поместить в один пакетный запрос.
Внимание! Не забудьте проиндексировать созданную временную таблицу. В качестве индексных полей следует указать все поля, которые используются в условии соединения.
Для вышеприведенного примера получится следующий пакетный запрос:
// Создать менеджер временных таблиц МенеджерВТ = Новый МенеджерВременныхТаблиц; Запрос = Новый Запрос; Запрос.МенеджерВременныхТаблиц = МенеджерВТ; // Текст пакетного запроса Запрос.Текст = " // Заполняем временную таблицу. Запрос к регистру лимитов. | ВЫБРАТЬ . | ПОМЕСТИТЬ Лимиты | ИЗ РегистрСведений.Лимиты | ГДЕ . | СГРУППИРОВАТЬ ПО . | ИНДЕКСИРОВАТЬ ПО . ; // Выполняем основной запрос с использованием временной таблицы ВЫБРАТЬ . ИЗ Документ.РеализацияТоваровУслуг ЛЕВОЕ СОЕДИНЕНИЕ Лимиты ПО . ;"
Пояснения
Во встроенном языке запросов 1С:Предприятия версии 8.0 отсутствовала возможность использовать временные таблицы и писать пакетные запросы. При этом часто было необходимо выполнять сложные вычисления в рамках одного запроса (то есть, одного цикла взаимодействия клиент - сервер 1С:Предприятия - сервер СУБД). Для решения таких задач использовались подзапросы - обращения не к объектам метаданных, а к выборкам из этих объектов. Как правило, подзапросы выполнялись с группировкой и часто использовались в соединениях.
Оптимизатор сервера СУБД (независимо от того, какую СУБД вы используете) не всегда может правильно оптимизировать подобный запрос. В данном случае, проблемой для оптимизатора является выбор правильного способа соединения. Существуют несколько алгоритмов соединения двух выборок. Выбор того или иного алгоритма зависит от того, сколько записей будет содержаться в одной и в другой выборке. В том случае, если вы соединяете две физические таблицы, СУБД может легко определить объем обоих выборок на основании имеющейся статистики. Если же одна из соединямых выборок представляет собой подзапрос, то понять, какое количество записей она вернет, становится очень сложно. В этом случае СУБД может ошибиться с выбором плана, что приведет к катастрофическому падению производительности запроса.
Переписывание запроса по приведенной выше методике имеет своей целью упростить работу оптимизатору СУБД. В переписанном запросе все выборки, участвующие в соединениях будут представлять собой физические таблицы, и СУБД сможет легко определить размер каждой выборки. Это позволит СУБД гарантированно выбрать самый быстрый из всех возможных планов. Причем, СУБД будет делать правильный выбор независимо ни от каких условий. Переписанный подобным образом запрос будет работать одинаково хорошо на любых СУБД, что особенно важно при разработке тиражных решений. Кроме того, переписанный подобным образом запрос лучше читается, проще для понимания и отладки.
Следует понимать, что переписав запрос таким образом, мы, возможно, внесли в него некоторое замедление за счет дополнительных накладных расходов - создания временных таблиц. Если СУБД не ошибется с выбором плана, то она, возможно, выполнит старый запрос быстрее, чем новый. Однако, это замедление всегда будет крайне незначительным. Размер замедления зависит от используемой СУБД и производительности оборудования. В типичном случае на создание одной временной таблицы может уйти несколько миллисекунд. То есть, эти замедления не могут оказать заметного влияния на производительность системы и как правило ими можно пренебречь.
Cоединения с виртуальными таблицами
Рекомендации
Если в запросе используется соединение с виртуальной таблицей языка запросов 1С:Предприятия (например, "РегистрНакопления.Товары.Остатки()") и запрос работает с неудовлетворительной производительностью, то рекомендуется вынести обращение к виртуальной таблице в отдельный запрос с сохранением результатов во временной таблице.
То есть, следует использовать ту же рекомендацию, что и в случае соединения с подзапросом.
Пояснения
Виртуальные таблицы, используемые в языке запросов 1С:Предприятия, могут разворачиваться в подзапросы при трансляции в язык SQL. Это связано с тем, что виртуальная таблица часто (но не всегда) получает данные из нескольких физических таблиц СУБД. Если вы используете соединение с виртуальной таблицей, то на уровне SQL оно может быть в некоторых случаях реализовано, как соединение с подзапросом. В этом случае оптимизатор СУБД может точно так же выбрать неоптимальный план, как при работе с подзапросом, использованным в языке 1С:Предприятия в явном виде.
Несоответствие индексов и условий запроса
Рекомендации
Убедитесь в том, что для всех условий, использованных в запросе, имеются подходящие индексы.
Условия используются в следующих секциях запроса:
Для каждого условия должен существовать подходящий индекс. Подходящим является индекс, удовлетворяющий следующим требованиям:
- 1. Индекс содержит все поля перечисленные в условии;
- 2. Эти поля находятся в самом начале индекса;
- 3. Эти поля идут подряд, то есть между ними не «вклиниваются» поля, не участвующие в условии запроса;
При создании объекта метаданных 1С:Предприятие автоматически создает индексы, которые должны подходить для работы большинства запросов.
Основные идексы, создаваемые 1С:Предприятием:
- индекс по уникальному идентификатору (ссылке) для всех объектных сущностей (справочники, документы и т.д.);
- индекс по регистратору (ссылке на документ) для таблиц движений регистров, подчиненных регистратору;
- индекс периоду и значениям всех измерений для итоговых таблиц регистров накопления;
- индекс периоду, счету и значениям всех измерений для итоговых таблиц регистров бухгалтерии.
Детальная информация по индексам, автоматически создаваемым 1С:Предприятием содержится в статье «Индексы таблиц базы данных 1С:Предприятия 8.1».
В тех случаях, когда автоматически созданных индексов недостаточно, можно дополнительно проиндексировать реквизиты объекта метаданных. Информация о том, какие индексы при этом будут созданы, содержится в этой же статье. Следует иметь в виду, что создание индекса ускоряет процесс поиска информации, но может несколько замедлить процесс ее изменения (добавления, редактирования и удаления). Поэтому индексы следует создавать осознанно и только в том случае, если точно известен запрос, для которого такой индекс необходим. Не следует создавать индексы "на всякий случай" или заведомо избыточные индексы. Например никогда не следует дополнительно индексировать первое измерение регистра, поскольку для поиска по значению первого измерения подходит основной индекс таблицы итогов, который автоматически создаст платформа.
Пояснения
Если в структуре базы данных отсутствует индекс, удовлетворяющий всем перечисленным условиям, то для получения результата СУБД будет вынуждена сканировать таблицу или один из ее индексов. Это приведет к увеличению времени выполнения запроса, а так же к возможному снижению параллельности системы, поскольку возрастет количество установленных блокировок.
Требования к индексу, перечисленные в рекомендациях, связаны с физической структурой индекса в СУБД. Эта структура представляет собой дерево значений проиндексированных полей. На первом уровне дерева находятся значения первого поля индекса, на втором - второго и так далее. Такая структура позволяет достичь высокой эффективности при поиске по индексу. Кроме того, она гарантирует отсутствие деградации производительности индекса с ростом количества данных.
Однако, индекс такой структуры, очевидно, может быть использован только строго определенным образом. Сначала необходимо провести поиск по значению первого поля индекса, затем - второго и так далее. Если, например, условие по первому полю индекса не указано, то индекс уже не сможет обеспечить быстрый поиск. Если указано условие по нескольким первым полям индекса, а затем одно или несколько полей индекса не задано, то индекс может быть использован только частично.
Примеры
В конфигурации описан регистр накопления ТоварыНаСкладах:
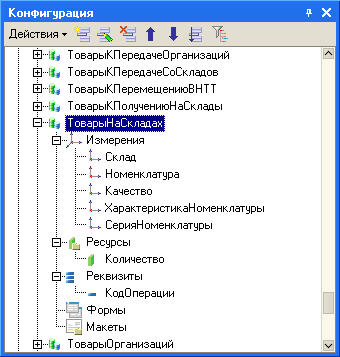
Платформа 1С:Предприятие автоматически создаст для таблицы остатков данного регистра индекс по периоду и всем измерениям в том порядке, в котором они перечислены в конфигураторе.
Рассмотрим несколько примеров запросов и проанализируем, смогут ли они оптимально выполняться при такой структуре данных.
Запрос 1
Запрос.Текст = "ВЫБРАТЬ | ТоварыНаСкладахОстатки.Склад, | ТоварыНаСкладахОстатки.Номенклатура, | ТоварыНаСкладахОстатки.Качество |ИЗ | РегистрНакопления.ТоварыНаСкладах.Остатки(, Номенклатура = &Номенклатура) КАК ТоварыНаСкладахОстатки";
В данном случае нарушено требование 2. В условии отсутствует отбор по первому полю индекса (Склад). Такой запрос не сможет выполниться оптимально. Для его выполнения серверу СУБД придется перебирать (сканировать) все записи таблицы. Время выполнения этой операции напрямую зависит от количества записей в таблице остатков регистра и может быть очень большим (и будет увеличиваться с ростом количества данных).
- Проиндексировать измерение «Номенклатура»
- Поставить измерение «Номенклатура» первым в списке измерений. Будьте внимательны при использовании этого метода. В конфигурации могут присутствовать другие запросы, которые могут замедлиться в результате этой перестановки.
Запрос 2
Запрос.Текст = "ВЫБРАТЬ | ТоварыНаСкладахОстатки.Склад, | ТоварыНаСкладахОстатки.Номенклатура, | ТоварыНаСкладахОстатки.Качество |ИЗ | РегистрНакопления.ТоварыНаСкладах.Остатки( | , | Качество = &Качество | И Склад = &Склад) КАК ТоварыНаСкладахОстатки";
В данном случае нарушено требование 3. Между измерениями «Склад» и «Качество» в структуре регистра находится измерение «Номенклатура», которое не задано в условии запроса. Этот запрос так же не сможет выполняться оптимально. При его выполнении СУБД выполнит поиск по первому полю индекса, но затем вынужденно просканирует некоторую его часть. Сканирование приведет к увеличению времени выполнения запроса и к блокировке избыточных записей в таблице, то есть к снижению общей пропускной способности системы.
- Добавить в запрос условие по измерению «Номенклатура»
- Убрать из запроса условие по измерению «Качество»
- Перенести «Номенклатуру» из измерений в реквизиты
- Поменять местами измерения «Номенклатура» и «Качество
Запрос 3
Запрос.Текст = "ВЫБРАТЬ | ТоварыНаСкладахОстатки.Склад, | ТоварыНаСкладахОстатки.Номенклатура, | ТоварыНаСкладахОстатки.Качество, | ТоварыНаСкладахОстатки.КоличествоОстаток |ИЗ | РегистрНакопления.ТоварыНаСкладах.Остатки( | , | Номенклатура = &Номенклатура | И Склад = &Склад) КАК ТоварыНаСкладахОстатки";
В этом случае требования соответствия индекса и запроса не нарушены. Данный запрос будет выполнен СУБД оптимальным способом. Обратите внимание на то, что порядок следования условий в запросе не обязан совпадать с порядком следования полей в индексе. Это не является проблемой и будет нормально обработано СУБД.
Использование логического ИЛИ в условиях
Рекомендации
Использование логического ИЛИ в секции ГДЕ запроса
Не следует использовать ИЛИ в секции ГДЕ запроса. Это может привести к тому, что СУБД не сможет использовать индексы таблиц и будет выполнять сканирование, что увеличит время работы запроса и вероянтность возникновения блокировок. Вместо этого следует разбить один запрос на несколько и объединить результаты.
ВЫБРАТЬ Товар.Наименование ИЗ Справочник.Товары КАК Товар ГДЕ Артикул = "001" ИЛИ Артикул = "002"
следует заменить на запрос
ВЫБРАТЬ Товар.Наименование ИЗ Справочник.Товары КАК Товар ГДЕ Артикул = "001" |ОБЪЕДИНИТЬ ВСЕ |ВЫБРАТЬ Товар.Наименование ИЗ Справочник.Товары КАК Товар ГДЕ Артикул = "002"
Включение пользователей в несколько ролей, каждая из которых имеет RLS
Если в конфигурации описано несколько ролей с условиями RLS, то не следует назначать одному пользователю более одной такой роли. Если один пользователь будет включен, например, в две роли с RLS - бухгалтер и кадровик, то при выполнении всех его запросов к их условиям будут добавляться условия обоих RLS с использованием логического ИЛИ. Таким образом, даже если в исходном запросе нет условия ИЛИ, оно появится там после добавления условий RLS. Такой запрос так же может выполняться неоптимально - медленно и с избыточными блокировками.
Вместо этого следует создать "смешанную" роль - "бухгалтер-кадровик" и прописать ее RLS таким образом, чтобы избежать использования ИЛИ в условии, а пользователя включить в эту одну роль.
Использование ИЛИ в условиях соединения
Не рекомендуется использовать логическое ИЛИ в условиях соединения, то есть в секции ПО запроса. Это так же может привести к выбору неоптимального плана и медленной работе запроса. Простого универсального способа переписать такой запрос без использования ИЛИ не существует. Следует проанализировать решаемую задачу и попытаться найти другой алгоритм ее решения.
Использование подзапросов в условии соединения
Рекомендации
Не следует использовать подзапросы в условии соединения. Это может привести к значительному замедлению запроса и (в отдельных случаях) к его полной неработоспособности на некоторых СУБД. Пример запроса с использованием подзапроса в условии соединения:
Запрос.Текст = "ВЫБРАТЬ | ОстаткиТоваров.Номенклатура КАК Номенклатура, | Цены.Цена КАК ЦенаПрошлогоМесяца |ИЗ | РегистрНакопления.ТоварыНаСкладах.Остатки(. ) КАК ОстаткиТоваров | ЛЕВОЕ СОЕДИНЕНИЕ РегистрСведений.Цена КАК Цены | ПО Цены.Номенклатура = ОстаткиТоваров.Номенклатура И | Цены.Период В ( | ВЫБРАТЬ МАКСИМУМ(ЦеныПрошлогоМесяца.Период) | ИЗ РегистрСведений.Цена КАК ЦеныПрошлогоМесяца | ГДЕ ЦеныПрошлогоМесяца.Период < НАЧАЛОПЕРИОДА(ОстаткиТоваров.Период, МЕСЯЦ) | И ЦеныПрошлогоМесяца.Номенклатура = ОстаткиТоваров.Номенклатура | ) | ГДЕ ОстаткиТоваров.Склад = &Склад";
В данном случае подзапрос в условии соединения используется для получения как бы "среза последних" на конец предыдущего периода. Причем, для каждой номенклатуры период может быть разным. Подобный запрос рекомендуется переписать с использованием временных таблиц. Например, это можно сделать следующим образом:
Запрос.Текст = " // Максимальные даты установки цен в прошлом периоде для данных номенклатур |ВЫБРАТЬ | ОстаткиТоваров.Номенклатура КАК Номенклатура, | МАКСИМУМ(Цены.Период) КАК Период |ПОМЕСТИТЬ ДатыПоНоменклатурам |ИЗ | РегистрНакопления.ТоварыНаСкладах.Остатки(. ) КАК ОстаткиТоваров | ЛЕВОЕ СОЕДИНЕНИЕ РегистрСведений.Цена КАК Цены | ПО Цены.Номенклатура = ОстаткиТоваров.Номенклатура И | Цены.Период < НАЧАЛОПЕРИОДА(ОстаткиТоваров.Период, МЕСЯЦ) | СГРУППИРОВАТЬ ПО ОстаткиТоваров.Номенклатура | ГДЕ ОстаткиТоваров.Склад = &Склад; // Выбрать данные по цене за найденный период |ВЫБРАТЬ | ДатыПоНоменклатурам.Номенклатура КАК Номенклатура, | Цены.Цена КАК ЦенаПрошлогоМесяца |ИЗ ДатыПоНоменклатурам | ЛЕВОЕ СОЕДИНЕНИЕ РегистрСведений.Цена КАК Цены | ПО Цены.Номенклатура = ОстаткиТоваров.Номенклатура И | Цены.Период = ДатыПоНоменклатурам.Период ";
Получение данных через точку от полей составного типа
Рекомендации
Если в запросе используется получение значения через точку от поля составного ссылочного типа, то при выполнении этого запроса будет выполняться соединение со всеми таблицами объектов, входящими в этот составной тип. В результате SQL текст запроса чрезвычайно усложняется, и при его выполнении оптимизатор СУБД может выбрать неоптимальный план. Это может привести к серьезным проблемам производительности и даже к неработоспособности запроса в отдельных случаях.
В частности, не рекомендуется обращаться к реквизитам регистратора регистра (например, "ТоварыНаСкладах.Регистратор.Дата") и т.п. При этом не важно в какой части запроса вы используете реквизит, полученный через точку от поля составного типа - в списке возвращаемых полей, в условии и т.п. Во всех случаях такое обращение может привести к проблемам производительности.
Общая рекомендация заключается в том, чтобы по возможности ограничить количество соединений в таких запросах. Для этого можно использовать следующие приемы:
- Избегайте избыточности при создании полей составных ссылочных типов . Указывайте ровно столько возможных типов для данного поля, сколько необходимо. Не следует без необходимости использовать типы "любая ссылка" или "ссылка на любой документ" и т.п. Вместо этого следует более тщательно проанализировать прикладную логику и назначить для поля ровно те возможные типы ссылок, которые необходимы для решения задачи.
- При необходимости жертвуйте компактностью хранения данных ради производительности . Если в запросе вам понадобилось значение, полученное через ссылку, то, возможно, это значение можно хранить непосредственно в данном объекте. Например, если при работе с регистром вам требуется информация о дате регистратора, вы можете завести в регистре соответствующий реквизит и назначать ему значение при проведении документов. Это приведет к дублированию информации и некоторому (незначительному) увеличению ее объема, но может существенно повысить производительность и стабильность работы запроса.
- При необходимости жертвуйте компактностью и универсальностью кода ради производительности . Как правило, для выполнения конкретного запроса в данных условиях не нужны все возможные типы данной ссылки. В этом случае, следует ограничить количество возможных типов при помощи функции ВЫРАЗИТЬ. Если данный запрос является универсальным и используется в нескольких разных ситуациях (где типы ссылки могут быть разными), то можно формировать запрос динамически, подставляя в функцию ВЫРАЗИТЬ тот тип, который необходим при данных условиях. Это увеличит объем исходного кода и, возможно, сделает его менее универсальным, но может существенно повысить производительность и стабильность работы запроса.
Пример
В данном запросе используется обращение к реквизитам регистратора. Регистратор является полем составного типа, которое может принимать значения ссылки на один из 56 видов документов.
Запрос.Текст = "ВЫБРАТЬ | Продажи.Регистратор.Номер, | Продажи.Регистратор.Дата, | Продажи.Контрагент, | Продажи.Количество, | Продажи.Стоимость |ИЗ | РегистрНакопления.Продажи КАК Продажи |ГДЕ .
SQL-текст этого запроса будет включать 56 левых соединений с таблицами документов. Это может привести к серьезным проблемам производительности при выполнении запроса. Однако, для решения данной конкретной задачи нет необходимости соединяться со всеми 56 видами документов. Условия запроса таковы, что при его выполнении будут выбраны только движения документов "РеализацияТоваровУслуг" и "ЗаказыПокупателя". В этом случае мы можем значительно ускорить работу запроса, ограничив количество соединений при помощи функции ВЫРАЗИТЬ().
Запрос.Текст = "ВЫБРАТЬ | ВЫБОР | КОГДА Продажи.Регистратор ССЫЛКА Документ.РеализацияТоваровУслуг | ТОГДА ВЫРАЗИТЬ(Продажи.Регистратор КАК Документ.РеализацияТоваровУслуг).Номер | КОГДА Продажи.Регистратор ССЫЛКА Документ.ЗаказПокупателя | ТОГДА ВЫРАЗИТЬ(Продажи.Регистратор КАК Документ.ЗаказПокупателя).Номер | КОНЕЦ ВЫБОРА КАК Номер, | ВЫБОР | КОГДА Продажи.Регистратор ССЫЛКА Документ.РеализацияТоваровУслуг | ТОГДА ВЫРАЗИТЬ(Продажи.Регистратор КАК Документ.РеализацияТоваровУслуг).Дата | КОГДА Продажи.Регистратор ССЫЛКА Документ.ЗаказПокупателя | ТОГДА ВЫРАЗИТЬ(Продажи.Регистратор КАК Документ.ЗаказПокупателя).Дата | КОНЕЦ ВЫБОРА КАК Дата, | Продажи.Контрагент, | Продажи.Количество, | Продажи.Стоимость |ИЗ | РегистрНакопления.Продажи КАК Продажи |ГДЕ | Продажи.Регистратор ССЫЛКА Документ.РеализацияТоваровУслуг | ИЛИ Продажи.Регистратор ССЫЛКА Документ.ЗаказыПокупателя";
Этот запрос является более громоздким и, возможно, менее универсальным (он не будет правильно работать для других ситуаций - когда возможны другие значения типов регистратора). Однако, при его выполнении будет сформирован SQL запрос, который будет содержать всего два соединения с таблицами документов. Такой запрос будет работать значительно быстрее и стабильнее, чем запрос в его первоначальном виде.
Фильтрация виртуальных таблиц без использования параметров
При использовании виртуальных таблиц в запросах, следует передавать в параметры таблиц все условия, относящиеся к данной виртуальной таблице. Не рекомендуется фильтровать виртуальные таблицы при помощи условий в секции ГДЕ и т.п. Такой запрос будет возвращать правильный (с точки зрения функциональности) результат, но СУБД будет намного сложнее выбрать оптимальный план для его выполнения. В некоторых случаях это может привести к ошибкам оптимизатора СУБД и значительному замедлению работы запроса.
Например, следующий запрос использует секцию ГДЕ запроса для выборки из виртуальной таблицы.
Запрос.Текст = "ВЫБРАТЬ | Номенклатура |ИЗ | РегистрНакопления.ТоварыНаСкладах.Остатки() |ГДЕ | Склад = &Склад";
Возможно, что в результате выполнения этого запроса сначала будут выбраны все записи виртуальной таблицы, а затем из них будет отобрана часть, соответствующая заданному условию. Было бы оптимальным вариантом ограничивать количество выбираемых записей на самом раннем этапе обработки запроса. Для этого следует передать условия в параметры виртуальной таблицы.
Запрос.Текст = "ВЫБРАТЬ | Номенклатура |ИЗ | РегистрНакопления.ТоварыНаСкладах.Остатки(, Склад = &Склад)";
SQL: подзапросы, их виды, корректное использование
Подзапросы, возвращающие единственное значение
Подзапросы (вложенные запросы), возвращающие единственное значение, наиболее часто применяются в случаях, когда значение определённого столбца в основном запросе требуется сравнить с некоторым единственным значением при помощи одного из операторов сравнения (=, , =). Значение, с которым производится сравнение, как раз и возвращается подзапросом (вложенным запросом).
Верные признаки того, что подзапрос вернёт одно единственное значение:
- в подзапросе применяется одна из агрегатных функций (COUNT, SUM, AVG, MAX, MIN);
- подзапрос извлекает значение уникального идентификатора, например, первичного ключа.
В остальных случаях нужно быть полностью уверенным, что условиям, указанным в секции WHERE подзапроса, соответствует единственное значение выбираемого столбца.
В примерах работаем с базой данных "Театр". Таблица Play содержит данные о постановках. Таблица Team - о ролях актёров. Таблица Actor - об актёрах. Таблица Director - о режиссёрах. Поля таблиц, первичные и внешние ключи можно увидеть на рисунке ниже (для увеличения нажать левой кнопкой мыши).

Пример 1. Вывести спектакли режиссёра John Barton. Запрос будет следующим:
SELECT Name FROM PLAY WHERE Dir_ID=( SELECT Dir_ID FROM DIRECTOR WHERE FName='John' AND LName='Barton')
Поскольку подзапрос возвращает значение уникального идентификатора, можно быть уверенным в том, что он вернёт единственное значение.
Более редкий случай использования подзапросов, возвращающих единственное значение - в запросах с предикатом BETWEEN, где подзапросы задают границы интервала.
Подзапросы, возвращающие множество значений
Подзапросы, возвращающие множество значений, могут применяться в запросах с предикатами IN и EXISTS и кванторными функциями ALL и ANY.
Пример 2. В таблице TEAM столбец Mainteam содержит данные о том, главная ли роль закреплена с спектакле за актёром. Значение столбца 'Y' означает "да", 'N' - "нет". Вывести список актёров, которые когда-либо исполняли главные роли. Запрос будет следующим:
SELECT FName, LName FROM ACTOR WHERE Actor_ID IN ( SELECT Actor_ID FROM TEAM WHERE Mainteam='Y')
Подзапрос вернёт множество значений FName и LName, которые через ключ Actor_ID будет передано в основной запрос и окончательно выведены в качестве результата.
На сайте есть отдельный урок о запросах с предикатом IN.
Пример 3. В таблице ACTOR (актёр) есть столбец SEX, содержащий данные о поле ('M' - мужской, 'F' - женский) актёра. Вывести спектакли, в которых играют только мужчины. Запрос будет следующим:
SELECT pl.* FROM PLAY pl WHERE NOT EXISTS ( SELECT 1 FROM TEAM te JOIN ACTOR ac ON ac.Actor_ID=te.Actor_ID WHERE te.Play_ID=pl.Play_ID AND ac.Sex='F')
Предикат NOT EXISTS принимает подзапрос как аргумент и оценивает его как подходящий, если значения sex для одного или более актёров в таблице actor не равны F.
На сайте есть подробный урок о запросах с предикатами EXISTS и NOT EXISTS.
Пример 4. Определить самый популярный жанр театра. Пишем запрос с использованием кванторной функции ALL:
SELECT Genre FROM PLAY GROUP BY Genre HAVING COUNT (*) >= ALL ( SELECT COUNT (*) FROM PLAY GROUP BY Genre)
Кванторная функция ALL проверяет значения количества жанров среди всех спектаклей и затем находит жанр с количеством большим, чем у любого другого жанра, или равным ему.
На сайте есть подробный урок о запросах с кванторными функциями ALL и ANY.
Некоррелирующие и коррелирующие подзапросы
Подзапрос, возвращающий результат или результаты, для получения которых значения указанного столбца не должны соотноситься (коррелировать) со значениями столбцов, указанных в основном запросе, называется некоррелирующим. Результат выполнения некоррелирующего запроса не зависит от значений, возвращаемых основным запросом. Обычно некоррелирующие запросы применяются в запросах, в которых значение определённого столбца сравнивается со значением, возвращаемым подзапросом, в запросах с предикатом IN, кванторными функциями ALL и ANY. Однако уже в запросах с предикатом EXISTS применяются коррелирующие подзапросы.
Подзапрос, возвращающий результат или результаты, для получения которых значения указанного столбца должны соотноситься (коррелировать) со значениями столбцов, указанных в основном запросе, называется коррелирующим. Иными словами, результат, выполнения подзапроса зависит от значений, возвращаемых основным запросом. Часто коррелирующие подзапросы применяются для получения значений одного из столбцов результирующей таблицы и в этих случаях подзапрос, заключённый в скобки, перечисляется через запятую вместе с именами столбцов из таблиц или соединения таблиц.
Пример 5. Вывести список актёров с количеством их ролей. Пишем следующий запрос с коррелирующим подзапросом:
SELECT DISTINCT a.Actor_ID, a.FName, a.LName, ( SELECT COUNT (*) FROM ACTOR a1 JOIN team t1 ON a1.Actor_ID=t1.ACTOR_ID WHERE a1.Actor_ID=a.Actor_ID GROUP BY a1.Actor_ID) AS NumRoles FROM ACTOR a JOIN team t ON a.Actor_ID=t.ACTOR_ID ORDER BY a.Actor_ID
В основном запросе происходит первое обращение к таблице ACTOR, которая получает псевдоним a. В подзапросе происходит второе обращение к таблице ACTOR, которая получает псевдоним a1. При этом в секции WHERE подзапроса указано условие: идентификаторы актёров, возвращаемые основным запросом и подзапросом, должны совпадать. Это условие - характерный признак коррелирующего подзапроса.