Связи между таблицами MS SQL: обзор основных отношений и типов соединения
Связи между таблицами в базе данных — основа хранения данных в СУБД.
Связи в базе данных MS SQL позволяют нормализировать БД, настроить отношение между данными таблиц и сделать эффективные выборки данных. Главное — понять, как настраивать и использовать связи между таблицами MS SQL. Это необходимое условие для работы с любой БД.
Ниже рассмотрим основные концепции связей: Foreign Key и JOINs.
Foreign Key
Создание связей MS SQL между таблицами происходит через внешний ключ (foreign key). Данный ключ связывает поле (значение) исходной таблицы с Primary Key внешней таблицы. Через внешний ключ можно не только производить выборку данных, но и контролировать удаление данных в главной таблице:
- NO ACTION — не производит никаких действий;
- SET NULL — зависимые данные установятся в NULL при удалении записи из главной таблицы (primary table);
- CASCADE — удаляются зависимые данные. Опасная операция. В реальной жизни используется редко.
Подробнее об этом — на курсе «Аналитик данных». За 12 месяцев разберетесь в основных данных, научитесь делать таблицы, соединять и обрабатывать несколько сразу, использовать оконные функции. Станете настоящим экспертом в аналитике!
ALTER TABLE ADD CONSTRAINT FK__ FOREIGN KEY () REFERENCES () ON UPDATE ON UPDATE
Типы соединения JOINs
Когда отношения между таблицами установлены, можно делать выборки данных из этих связанных таблиц.
Существует несколько механизмов соединения двух таблиц в запросе: это основные типы JOINs для MS SQL SERVER. И они практически всегда совпадают для всех реляционных СУБД.
Рассмотрим основные типы JOINs. Будем считать, что у нас есть левая и правая таблицы, которые соединяем через JOIN. *Левая и правая относительно слова JOIN.
Есть несколько механизмов соединения двух таблиц в запросе. Например, Oracle содержит Natural Join, который соединяет колонки с одинаковыми именами в таблицах. Используется крайне редко.
Обо всех способах соединения — на курсе «Аналитик данных». Уделяйте учебе всего два часа в день — и научитесь обновлять, удалять и добавлять записи, использовать разные соединения, чтобы решать реальные задачи.
LEFT (OUTER) JOIN
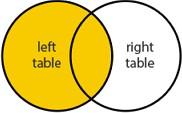
Всегда выводите данные по левой таблице. Если правая таблица не содержит связанных данных, то выводите NULL для этих значений.
select * from A left join B on A.ID = B.A_ID
| A1 | B1 |
| A2 | B2 |
| A3 | NULL |
RIGHT (OUTER) JOIN
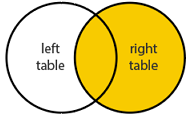
Обратное от Left Join. Используют редко. Всегда можно переписать на Left Join — тогда запрос легче читать. В частных случаях бывает, что Right Join дает лучшую статистику выполнения и оптимизирует запрос.
A left join B = B right join A:
select * from B right join A on A.ID = B.A_ID
| A1 | B1 |
| A2 | B2 |
| A3 | NULL |
Аналитик данных: новая работа через 5 месяцев
Получится, даже если у вас нет опыта в IT
INNER JOIN
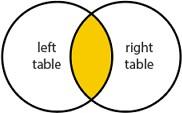
Выводите значения для строки из левой таблицы, только если есть связанные данные в правой таблице. Часто используют, чтобы отфильтровать данные левой таблицы и выводить только те записи, по которым есть значения в правой.
На курсе «Аналитик данных» вы не только изучите теорию, но и выполните практические задания. Если возникнут сложности — помогут кураторы с реальным опытом в аналитике. Благодаря их помощи подготовите интересные проекты для портфолио.
select * from A inner join B on A.ID = B.A_ID -- аналог запроса на left join select * from A left join B on A.ID = B.A_ID where B.ID is not null
| A1 | B1 |
| A2 | B2 |
CROSS JOIN
Это пересечение всех строк из левой таблицы со всеми строками правой таблицы.
select * from A cross join B
| A1 | B1 |
| A1 | B2 |
| A2 | B1 |
| A2 | B2 |
FULL JOIN
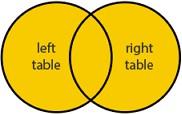
Представьте, что это смешанное сочетание Left Join и Right Join. Вначале выводятся значения левой таблицы, а правой заполняются NULL, затем — наоборот.
Запрос выводит пересечение значений. Если нет пересечений, то выводит значения по A и B c NULL:
select * from A full join B on A.ID = B.A_ID
| A1 | B1 |
| A2 | B2 |
| A3 | NULL |
| NULL | B4 |
Типы отношений между таблицами
Используем Foreign Key и JOINs и создадим реальный пример бизнес-задачи. А еще рассмотрим настройку связей между таблицами.
Введем сущности Clinics, Doctors, Patients и Appointments.
- Доктор работает или не работает только в одной клинике.
- У доктора может быть вышестоящий менеджер.
- Пациент может обращаться в разные клиники к разным докторам.
Создадим таблицы БД, пока без связей с сурогатными Primary Keys:
CREATE TABLE dbo.Clinics ( ID int, Name varchar(100) COLLATE SQL_Latin1_General_CP1_CI_AS NOT NULL, CONSTRAINT Clinics_PK PRIMARY KEY (ID) ); CREATE TABLE dbo.Patients ( ID int, Name varchar(100) COLLATE SQL_Latin1_General_CP1_CI_AS NOT NULL, CONSTRAINT Patients_PK PRIMARY KEY (ID) ); CREATE TABLE dbo.Doctors ( ID int, Name varchar(100) COLLATE SQL_Latin1_General_CP1_CI_AS NOT NULL, Clinic_ID int NULL, Manager_ID int NULL, CONSTRAINT Doctors_PK PRIMARY KEY (ID) ); CREATE TABLE dbo.Appointments ( ID int, [Date] datetime2(0) NOT NULL, Patient_ID int NOT NULL, Doctor_ID int NOT NULL, CONSTRAINT Appointments_PK PRIMARY KEY (ID) );
insert into dbo.Clinics values (1, 'First Clinic'), (2, 'Second Clinic') insert into dbo.Doctors values (10, 'Doctor', 1, NULL), (11, 'Assistent Doctor', 1, 10), (12, 'Another Doctor', 2, NULL), (13, 'Retired Doctor', NULL, NULL), (15, 'Assist 2 Doctor', 1, 11) insert into dbo.Patients values (100, 'First Patient'), (101, 'Second Patient') insert into dbo.Appointments values (1000, GETDATE(), 100, 10), (1001, GETDATE(), 101, 10), (1002, GETDATE(), 100, 12)
Отношения «один к одному»
Используйте данную связь, когда значению из таблицы соответствует только одна запись из внешней таблицы. «Доктор может работать только в одной клинике». Можем предположить, что связь между Clinics и Doctors будет «один к одному»:
ALTER TABLE dbo.Doctors ADD CONSTRAINT FK_Doctors_ClinicID FOREIGN KEY (Clinic_ID) REFERENCES dbo.Clinics(ID);
select d.Name, c.Name from dbo.Doctors d left join dbo.Clinics c on c.ID = d.Clinic_ID;
Отношение «один ко многим»
Одной записи из таблицы соответствуют несколько записей из внешней. Данный тип связи очень распространен при построении схемы БД.
«Хотя доктор может принадлежать только одной клинике, клиники, в свою очередь, содержат штат докторов». Это отношение «один ко многим»:
select c.Name, d.Name from dbo.Clinics c inner join dbo.Doctors d on d.Clinic_ID = c.ID;
| CLINIC | DOCTOR |
| First Clinic | Doctor |
| First Clinic | Assistent Doctor |
| First Clinic | Assist 2 Doctor |
| Second Clinic | Another Doctor |
Отношение «многие ко многим»
Организуется через промежуточную таблицу, в которой есть внешние ключи на разные таблицы.
О временных таблицах вы подробнее узнаете на курсе «Аналитик данных». Научитесь работать с временными таблицами, использовать оконные функции и соединять таблицы в SQL, применять их для сложных запросов.
В таблице Appointments есть связь на таблицы Doctors и Patients. Таким образом, организована связь между пациентами и докторами: пациент может посещать нескольких докторов, а доктора — принимать нескольких пациентов.
ALTER TABLE dbo.Appointments ADD CONSTRAINT FK_Appointments_DoctorID FOREIGN KEY (Doctor_ID) REFERENCES dbo.Doctors(ID); ALTER TABLE dbo.Appointments ADD CONSTRAINT FK_Appointments_PatientID FOREIGN KEY (Patient_ID) REFERENCES dbo.Patients(ID);
Это довольно распространенный вопрос на собеседовании для SQL-разработчика. Если программист может на примере объяснить, как строится связь «многие ко многим», — это уже хороший показатель для интервьюера.
Как получить список посещений пользователя с указанием клиники и докторов:
select p.Name, a.[Date], d.Name, c.Name from dbo.Patients p inner join dbo.Appointments a on a.Patient_ID = p.ID inner join dbo.Doctors d on d.ID = a.Doctor_ID inner join dbo.Clinics c on c.ID = d.Clinic_ID where p.ID = 100;
| PATIENT | DATE | DOCTOR | CLINIC |
| First Patient | 2022-08-06 07:41:45.000 | Doctor | First Clinic |
| First Patient | 2022-08-06 07:41:45.000 | Another Doctor | Second Clinic |
Связь с самим собой
Такой тип связи называется рекурсивным, или иерархическим: связывание строки со строкой из той же таблицы. Полезно при отображении древовидной структуры.
Таблица Doctors содержит колонку Manager, в которой указано, кто из докторов является менеджером текущего доктора. Здесь связь на строку из той же таблицы докторов.
Как рекурсивно получить список докторов, у которых определенный доктор является вышестоящим менеджером:
with cte as ( select d.ID, d.Name from dbo.Doctors d where d.ID = 10 union all select d2.ID, d2.Name from dbo.Doctors d2 inner join cte on cte.ID = d2.Manager_ID ) select * from cte
Как создать связь между таблицами в sql
Для создания связи между таблицами в SQL используется внешний ключ FOREIGN KEY. Внешний ключ определяет связь между двумя таблицами на основе значения определенного столбца.
Предположим, у вас есть две таблицы: orders и customers. Каждый заказ относится к определенному клиенту, поэтому необходимо установить связь между таблицами. Для этого нужно определить внешний ключ в таблице orders:
CREATE TABLE customers ( customer_id INT PRIMARY KEY, customer_name VARCHAR(50) ); CREATE TABLE orders ( order_id INT PRIMARY KEY, order_date DATE, customer_id INT, FOREIGN KEY (customer_id) REFERENCES customers(customer_id) ); В этом примере мы создаем таблицы customers и orders. Затем мы определяем столбец customer_id как внешний ключ в таблице orders с помощью ключевого слова FOREIGN KEY. Мы указываем, что этот внешний ключ связывает столбец customer_id в таблице orders со столбцом customer_id в таблице customers.
После создания связи между таблицами вы можете использовать операторы JOIN для объединения этих таблиц и выполнения запросов, используя данные из обеих таблиц.
Создаём простые связи в базе данных
В статье про виды баз данных мы рисовали простую схему базы для интернет-магазина — в ней товары, клиенты и покупки были связаны между собой, как в примере ниже. Зайдя в товары, можно посмотреть, сколько чего продано и кто это купил.
Сегодня мы сделаем то же самое, но уже в настоящей базе данных и с таблицами.

Что понадобится
Это простой проект, поэтому всё, что нам будет нужно, — это установленная MySQL на домашнем компьютере или на сервере. Удалённо подключаться к самой базе мы пока не будем, а вместо этого попрактикуемся в SQL-запросах. Если базы нет ни там ни там, поработайте в онлайн-компиляторе SQL — главное, не перезагружайте страницу.
Мы уже коротко писали о том, что такое SQL-запрос и как он выглядит, поэтому, чтобы было проще, перечитайте статью про язык SQL, а потом возвращайтесь сюда.
Таблица с товарами
В таблице с товарами у нас будет три столбца, причём главным будет название товара:
- Название ← по этому параметру мы будем связывать эту таблицу с другой.
- Количество ← остаток на складе.
- Цена.
Связь между таблицами нам понадобится для связи товаров с покупками — при продаже мы будем брать из товаров цену и уменьшать остаток на складе.
Важная оговорка: мы намеренно делаем связь по названию, а не по id товара или другому служебному полю, как это принято при создании связей. А всё потому, что мы хотим повторить схему связей как на рисунке в начале — чтобы можно было в любой момент посмотреть на схему и понять, что откуда берётся и как что связывается. В боевом проекте мы бы делали связи строго по ID товаров.
Чтобы сделать такую таблицу, откроем консоль MySQL командой mysql -u root и выберем нашу учебную базу thecodeDB командой USE thecodeDB :

Теперь создадим в базе таблицу с товарами:
CREATE TABLE goods (
product VARCHAR(20) PRIMARY KEY,
count INT,
price INT
);

Разберём команду подробнее:
- CREATE TABLE goods ← создать таблицу с названием goods;
- product VARCHAR(20) PRIMARY KEY ← первое поле будет называться product, название товара может состоять из 20 символов, а ещё это поле у нас будет уникальным и мы будем использовать его для связи с другой таблицей;
- count INT ← второе поле с названием count, в нём будем хранить количество товаров, а для этого нам понадобится целочисленный тип данных INT.
- price INT ← поле с названием price, где будет цена за штуку.
Заполняем товары
Сейчас таблица пустая — мы в этом убедимся, выполнив команду SELECT * FROM goods; , что означает «Выбери все записи из таблицы goods»:

Заполним таблицу товарами, используя расширенную версию команды INSERT, — в ней нужно явно указать, какое значение в какое поле отправляется:
INSERT INTO goods SET
product = ‘стол’,
count = 2,
price = 3000;

Проверим, добавилась ли запись — выведем всё содержимое таблицы с товарами:

Точно так же добавим два остальных товара:

Заполняем таблицу с клиентами
Теперь, когда мы знаем, как создавать и заполнять таблицы, сделаем таблицу с клиентами, причем поле «номер телефона» пометим как UNIQUE, потому что номер телефона будет уникальным для каждого покупателя.
Ещё мы сделаем поле id, где будет храниться код покупателя. Обратите внимание на параметр AUTO INCREMENT — он означает, что при каждом добавлении нового клиента в базу код покупателя будет автоматически увеличиваться на единицу.
CREATE TABLE clients (
name VARCHAR(40),
phone VARCHAR(10) UNIQUE,
id INT AUTO_INCREMENT PRIMARY KEY
);
Заполним таблицу первыми клиентами, при этом id нам указывать не нужно — база сама будет вести нумерацию клиентов:
INSERT INTO clients SET
name = ‘Миша’,
phone = 9208381096;
INSERT INTO clients SET
name = ‘Наташа’,
phone = 9307265198;
INSERT INTO clients SET
name = ‘Саша’,
phone = 9307281096;

Cоздаём таблицу с покупками и связываем всё вместе
Сейчас у нас есть две таблицы — с товарами и клиентами. Теперь сделаем самое интересное — создадим третью таблицу с покупками, где используем данные из двух других таблиц.
Чтобы это сделать, нам понадобится параметр FOREIGN KEY, который отвечает за связь главной и зависимой таблицы. Работает он так:
- В новой таблице мы хотим использовать название товара и код клиента.
- Эти два поля будут связаны с двумя таблицами — одна с товарами, а другая с клиентами.
- Чтобы это сделать, мы создаём два поля, а потом внизу указываем с помощью параметра FOREIGN KEY, из какой таблицы их брать.

Сделаем тестовую покупку — добавим в таблицу с заказами запись о том, что Миша купил 2 табурета:
INSERT INTO orders SET
product = ‘табурет’,
amount = 2,
client_id = 1;

Но если мы попробуем добавить в таблицу запись о покупке товара, которого нет в таблице с товарами, база выдаст ошибку. Всё дело в том, что параметр FOREIGN KEY сначала проверит, есть ли указанный товар в таблице с товарами, и если его нет — не даст ничего записать в таблицу:

Что дальше
Чтобы посмотреть информацию о клиенте, который сделал заказ, можно использовать команду SELECT * FROM orders, clients WHERE orders.client_id = clients.id; .
Распарсим этот запрос:
SELECT — «выбери», то есть «выведи», «достань»;
FROM orders, clients — из таблиц orders и clients;
WHERE — если оно подходит под условие, что…;
orders.client_id = clients.id; — …айдишник клиента в таблице orders совпадает с айдишником клиента в таблице clients.
В ответ на такой запрос база данных выведет все записи из обеих таблиц с заказами и клиентами, где совпадает id клиента:

SELECT — одна из основных команд в SQL-запросах, и с ней мы будем работать чаще всего. У неё много параметров и возможностей для конструирования запросов, поэтому в следующий раз мы займемся только ей.
Читаете «Код»? Зарабатывайте на коде
Сфера ИТ и разработки постоянно растёт и требует новых кадров. Компании готовы щедро платить даже начинающим разработчикам, а опытных вообще отрывают с руками. Обучиться на разработчика можно в «Яндекс Практикуме».
Получите ИТ-профессию
В «Яндекс Практикуме» можно стать разработчиком, тестировщиком, аналитиком и менеджером цифровых продуктов. Первая часть обучения всегда бесплатная, чтобы попробовать и найти то, что вам по душе. Дальше — программы трудоустройства.
2.8. Связанные таблицы

На данный момент мы писали достаточно простые запросы, потому что использовали только одну таблицу. Но мы же создали в прошлой главе 4-е таблицы, и хотелось бы научиться связывать их в одно целое. Я бы не стал усложнять базу данных, создавая справочники, если бы связь не была возможной.
Давайте попробуем связать две таблицы на примере должностей. В таблице Peoples у нас есть поле «idPosition». В этом поле содержится идентификатор (первичный ключ) строки, с которой связана запись со строкой из таблицы «tbPosition». Следующий пример показывает, как можно связать эти таблицы:
SELECT * FROM tbPeoples, tbPosition WHERE tbPeoples.idPosition=tbPosition.idPosition
Первая строка, как всегда говорит, что надо вывести все поля (SELECT *). Вторая строка говорит, из каких таблиц надо получать данные (FROM tbPeoples, tbPosition). На этот раз у нас здесь указано сразу две таблицы – работники и должности. Третья строка показывает связь:
tbPeoples.idPosition=tbPosition.idPosition
Для того, чтобы указать к какой таблице относиться поле «idPosition» (поле с таким именем есть в обеих таблицах, которые мы используем) мы записываем полное имя поля как ИмяБазы.ИмяПоля. Если имя поля уникально для обеих таблиц (как «vcFamil», которое есть только в таблице tbPeolpes), то можно имя таблицы опускать. Именно поэтому мы раньше опускали имя таблицы, когда использовали поля в секции SELECT и WHERE, ведь мы работали только с одной таблицей, и никаких конфликтов не могло быть. Как только мы указали две таблицы в секции FROM, сразу возникает вероятность встретиться с конфликтами имен полей.
Итак, в секции WHERE мы указываем, что поле «idPosition» из таблицы tbPeoples равно полю «idPosition» из таблицы tbPosition.
Связь необходима. Если ее не указать, то результат будет совершенно другим. Посмотрим, что произойдет, если не указывать связь, а просто выбрать данные из двух таблиц:
SELECT * FROM tbPeoples, tbPosition
Результат выполнения этого запроса показан на рисунке 2.4. На рисунке я немного изменил результат, чтобы поле «idPosition» из таблицы tbPeoples находилось рядом с одноименным полем (с которым происходит связь) из таблицы tbPosition. Выделенный фрагмент содержит поля, которые принадлежат таблице должностей.
Теперь посмотрим на строку Иванова. Обратите внимание, что их много. Иванов связался со всеми существующими должностями. Потом идут строки Петрова, который так же связался со всеми возможными должностями. Таким образом, количество строк в результате равно количеству строк из первой таблицы умноженное на количество строк из второй таблицы. Такое объединение называется ортогональным или декартовым.
Теперь посмотрим, что означает связь:
tbPeoples.idPosition=tbPosition.idPosition
Будем смотреть на эту команду не как на связь, а на как простое ограничение WHERE, которое говорит, что в результате поле «idPosition» в обоих, таблицах должны быть равны. Посмотрите на результат работы запроса без связи. Где значения этих полей равны? Для Иванова это та строка, где связь произошла с должностью генерального директора. Для Петрова это связь с коммерческим директором и т.д. Таким образом, все лишние записи отбрасываются, и мы получаем в результате только те строки, которые связаны по правильному ключу.
Почему база данных сама не указывает связь? Просто среди таблиц может быть несколько ключей, в том числе, две таблицы могут связываться разными способами и сервер просто не может знать, какая именно связь нам нужна в данный момент. Например, исходя из практики, фамилия, имя, отчество и дата рождения образуют уникальное сочетание. Вы можете попытаться связать две таблицы по этим данным, не обращая внимания на внешние ключи, чтобы определить для себя какие-то дополнительные сведения.
При написании связи нам пришлось писать полные имена таблиц. Чтобы этого не приходилось делать, в запросе можно создавать псевдонимы. Псевдонимы создаются в секции FROM, ставятся через пробел после имени таблицы, и действуют только внутри этого запроса:
SELECT * FROM tbPeoples pl, tbPosition ps WHERE pl.idPosition=ps.idPosition
В данном запросе у нас используется две таблицы и для каждой из них указывается псевдоним. Для таблицы tbPeoples это псевдоним pl, а для таблицы tbPosition это ps. В качестве псевдонима может выступать любое имя из любого количества букв. Я чаще всего использую первую букву, если она не будет конфликтовать с другими именами. В данном случае имена двух таблиц начинается с буквы p, вот и приходиться использовать две буквы.
В секции WHERE теперь не надо писать полное имя таблицы. Достаточно только указывать псевдоним:
pl.idPosition=ps.idPosition
Удобство от использования псевдонимов очень хорошо заметно, когда вы будете связывать несколько таблиц. Давайте посмотрим, как связывать три таблицы:
SELECT * FROM tbPeoples pl, tbPosition ps, tbPhoneNumbers pn WHERE pl.idPosition=ps.idPosition AND pl.idPeoples=pn.idPeoples
В секции FROM перечислены уже три таблицы, а в секции WHERE наведены две связи. Таблица tbPeoples связана с таблицей должностей, а вторая связь связывает таблицу tbPeoples c таблицей телефонов.
У нас в таблице работников 19 записей, а в таблице телефонов 18 строк. Проанализируйте результат и вы увидите, что некоторые работники имеют по несколько номеров телефонов. Например, строка Иванова встречается 3 раза, но с разными номерами. Те работники, которые не имеют телефонов, в результат не попали. Почему? Просто нет связи, а значит условие pl.idPeoples=pn.idPeoples не срабатывает.
Использование жесткого объединение с помощью знака равенства называют внутренним объединением. Чтобы увидеть записи, которые не связаны, нужно использовать внешнее объединение, которое бывает левым или правым.
Как же тогда увидеть всех работников, и при этом наладить связь? Для этого используются левые объединения:
SELECT * FROM tbPeoples pl, tbPosition ps, tbPhoneNumbers pn WHERE pl.idPosition=ps.idPosition AND pl.idPeoples*=pn.idPeoples
Самое интересное кроется как раз в последнем условии:
pl.idPeoples*=pn.idPeoples
Обратите внимание, что слева от знака равно стоит знак умножения или проще – звездочка. Это значит, что из таблицы работников (tbPeoples, которая находиться со стороны звездочки) нужно взять все строки, а если есть связь с таблицей, указанной справа, то отобразить ее.
Выполните этот запрос, и вы увидите всех работников. У тех, у кого нет номера телефона, поля из таблицы tbPhoneNumbers будут содержать нулевые значения NULL.
Использование знака * для не жесткого объединения описано в стандарте SQL, но я говорил, что не все базы данных поддерживают этот стандарт полностью. Например, MS Access позволяет создавать левые объединения, но здесь это делается совершенно по-другому. Мы рассмотрим этот метод в главе 2.8.
Когда мы связываем таблицы жестко с помощью знака равно, такое объединение называют внутренним. Когда мы используем не жесткое объединение со звездочкой, то оно бывает правым или левым. Чтобы вам проще было понять, где какое направление – посмотрите на звездочку. Мы ее поставили слева, значит, объединение было левым. Если бы звездочка была справа от знака равенства, то объединение стало бы правым.
Чтобы получить правое объединение, достаточно поменять поля местами:
SELECT * FROM tbPeoples pl, tbPosition ps, tbPhoneNumbers pn WHERE pl.idPosition=ps.idPosition AND pn.idPeoples=*pl.idPeoples
Вот теперь знак звездочки находиться справа. Как видите, разница в них небольшая, но она значительна при использовании объединения таблиц по методу MS.
Псевдонимы можно использовать в любой секции, даже в секции SELECT:
SELECT pl.vcFamil, pl.vcName, pl.vcSurname, ps.vcPositionName, pn.vcPhoneNumber FROM tbPeoples pl, tbPosition ps, tbPhoneNumbers pn WHERE pl.idPosition=ps.idPosition AND pl.idPeoples*=pn.idPeoples
Если быть более точным, то бывают случаи, когда использовать псевдонимы необходимо. Если есть имя поля, которое присутствует одновременно в обеих таблицах, то для его объявления в секции SELECT необходимо явно указать таблицу. Например, попробуйте добавить в список SELECT поле «idPeoples», без указания имени таблицы или псевдонима. В ответ на этот запрос, сервер выдаст ошибку: Ambiguous column name ‘idPeoples’ (двусмысленное имя колонки «idPeoples»). Сервер не знает, значение колонки «idPeoples», из какой таблицы нужно вернуть пользователю. Это вы знаете, что благодаря сравнению pl.idPeoples*=pn.idPeoples в результате все равно обе колонки будут содержать одно и то же значение, но сервер на это не надеется и даже не пытается понять, а просто выдает ошибку о двусмысленности.
При использовании связанных таблиц очень часто бывает необходимость выбрать одну таблицу полностью, а остальные могут выбираться частично. Например, давайте выберем из таблицы «tbPeoples» только ФИО, а из таблиц должностей и телефонов все поля:
SELECT vcFamil, vcName, vcSurname, ps.*, pn.* FROM tbPeoples pl, tbPosition ps, tbPhoneNumbers pn WHERE pl.idPosition=ps.idPosition AND pl.idPeoples*=pn.idPeoples
Обратите внимание, что поля, которые нам нужны из таблицы tbPeoples — перечисляются, а чтобы не перечислять все поля остальных таблиц, мы просто пишем ps.* или pn.*. То есть знак звездочки, означающий вывод всех полей относится не ко всем таблицам, а только к перечисленным.
В главе 1.2.6 мы рассматривали пример создания таблицы, в которой внешний ключ был связан с первичным ключом той же самой таблицы. В нашей тестовой базе данных такой таблицей является tbPosition, где хранятся должности работников. В этой таблице поле «idParentPosition» связано с первичным ключом «idPosition» этой же таблицы и предназначено для указания названия должности, которая является главной. Таким образом, можно построить дерево главный-подчиненный.
Давайте попробуем вывести табличку из двух полей, где первое поле будет отображать название должности, а второе – главную должность. Вот как это будет выглядеть в виде SQL запроса:
SELECT p1.vcPositionName AS 'Должность', p2.vcPositionName AS 'Главная должность' FROM tbPosition p1, tbPosition p2 WHERE p1.idParentPosition*=p2.idPosition
Прежде чем мы разберем этот запрос, давайте посмотрим на результат его работы:
ДОЛЖНОСТЬ ГЛАВНАЯ ДОЛЖНОСТЬ Генеральный директор NULL Коммерческий директор Генеральный директор Директор по общим вопросам Генеральный директор Начальник отдела снабжения Коммерческий директор Начальник отдела сбыта Коммерческий директор Начальник отдела кадров Директор по общим вопросам ОТиЗ Директор по общим вопросам Бухгалтерия Коммерческий директор Менеджер по снабжению Начальник отдела снабжения Менеджер по продажам Начальник отдела сбыта
Первая строка соответствует должности генерального директора. Это самый главный человек в компании, поэтому для нее во второй колонке указан NULL, т.е. главной должности нет.
Следующая строка в первой колонке содержит должность коммерческого директора. Вполне логично, что она подчиняется генеральному директору, что и отображено во второй колонке результата.
Теперь посмотрим на SQL запрос, с помощью которого мы получили эти данные. Для начала посмотрим на секцию FROM, где дважды указана одна и та же таблица «tbPosition», но с разными псевдонимами p1 и p2. В секции WHERE мы наводим связь между псевдонимами одной и той же таблицы:
p1.idParentPosition*=p2.idPosition
Таким образом, через псевдонимы мы указали связь внутри одной и той же таблицы. В секции SELECT мы отображаем имя должности из первого псевдонима и имя из второго.
Теперь посмотрите на следующий запрос:
SELECT p1.vcPositionName AS 'Должность', p2.vcPositionName AS 'Главная должность', p3.vcPositionName AS 'Главная для главной' FROM tbPosition p1, tbPosition p2, tbPosition p3 WHERE p1.idParentPosition=p2.idPosition AND p2.idParentPosition*=p3.idPosition
Здесь мы дважды использовали связь таблицы саму на себя. Результат работы этого запроса:
Должность Главная должность Главная для главной Коммерческий директор Генеральный директор NULL Директор по общим вопросам Генеральный директор NULL Начальник отдела снабжения Коммерческий директор ГенеральныйДиректор Начальник отдела сбыта Коммерческий директор ГенеральныйДиректор
Давайте теперь напишем запрос, который отобразит все записи из всех связанных таблиц нашей тестовой базы данных. А таблиц у нас всего 4, но в нашей секции FROM будет пять таблиц, потому что дважды будет ссылка на таблицу должностей, чтобы отобразить должность текущего работника и должность начальника:
SELECT pl.vcFamil, pl.vcName, pl.vcSurname, dDateBirthDay, p1.vcPositionName AS 'Должность', p2.vcPositionName AS 'Начальник', pn.vcPhoneNumber, pt.vcTypeName FROM tbPeoples pl, tbPosition p1, tbPosition p2, tbPhoneNumbers pn, tbPhoneType pt WHERE pl.idPosition=p1.idPosition AND p1.idParentPosition*=p2.idPosition AND pn.idPeoples=pl.idPeoples AND pt.idPhoneType=pn.idPhoneType
Попробуйте разобраться в этом запросе. Если вы поймете его, то можно считать, что тема связанных таблиц усвоена удачно.
Саязанные таблицы в стиле MS
Объединение по стандарту SQL, который мы рассматривали в главе 2.7, описывает условие связи в секции WHERE. В MS зачем-то связи перенесли в секцию FROM. На мой взгляд, это как минимум не удобно для создания и для чтения связей. Стандартный вариант намного проще и удобнее. И все же, метод MS мы рассмотрим, ведь только с его помощью в MS Access можно создать левое или правое объединение, и этот же метод поддерживается в MS SQL Server.
Ортогональное объединение по методу MS, т.е. без указания связи:
SELECT * FROM tbPeoples CROSS JOIN tbPosition
Внутреннее объединение (эквивалентно знаку равенства) по методу MS описывается следующим образом:
SELECT * FROM tbPeoples pl INNER JOIN tbPosition ps ON pl.idPosition=ps.idPosition
Как видите, для этого метода не нужна секция WHERE, но зато намного больше всего нужно писать. Вначале мы описываем, что нам нужно внутреннее объединение (INNER JOIN). Слева и справа от этого оператора указываются таблицы, которые нужно связать. После этого ставиться ключевое слово ON, и только теперь наводим связь между полями связанных таблиц. Таким образом, этот запрос эквивалентен следующему:
SELECT * FROM tbPeoples pl, tbPosition ps WHERE pl.idPosition=ps.idPosition
Самая большая путаница начинается, когда нужно объединить три таблицы в одно целое. Посмотрите на следующий запрос:
SELECT * FROM tbPeoples pl LEFT OUTER JOIN tbPhoneNumbers pn ON pl.idPeoples=pn.idPeoples INNER JOIN tbPosition ps ON pl.idPosition=ps.idPosition
Сначала объединяются таблицы tbPeoples и tbPhoneNumbers через внешнее левое объединение (LEFT OUTER JOIN). Затем указывается связь между этими таблицами. А вот теперь результат объединение, связываем внутренним объединением (INNER JOIN) с таблицей tbPosition. Внимательно осмотрите запрос, чтобы понять его формат, и что в нем происходит.
Чтобы получить правое объединение, необходимо просто поменять перечисление таблиц местами:
SELECT * FROM tbPhoneNumbers pn RIGHT OUTER JOIN tbPeoples pl ON pl.idPeoples=pn.idPeoples INNER JOIN tbPosition ps ON pl.idPosition=ps.idPosition
Меняется местами перечисление таблиц, а вот порядок указания связанных полей не имеет особого значения и здесь ничего не меняется.
Если честно, то мне не очень нравиться объединение по методу Microsoft. Какое-то оно неудобное и громоздкое. Даже не знаю, зачем его придумали, когда в стандарте есть все то же самое, только намного проще и нагляднее.