5 фишек Яндекс.Музыки, о которых должен знать каждый
Буквально на днях в России перестал работать Spotify. Если раньше пользователи могли просто обойтись без подписки Premium и слушать треки в бесплатной версии (пусть и с рекламой), то сейчас и этого сделать не получится. Очевидно, что приходится рассматривать альтернативные варианты. По факту, выбирать толком-то и не надо: Яндекс.Музыка уже давно стала лучшим музыкальным стриминговым сервисом в России. Но есть и другая проблема: при переходе из одной площадки на вторую возникают неясности. Интерфейс другой, функциональность отличается и так далее. Специально по этому случаю мы собрали для вас 5 функций Яндекс.Музыки, которые облегчат вам переход на эту платформу. Ну, а если вы пользуетесь Яндекс.Музыкой давно, все равно заглядывайте, узнаете много нового!
Рассказываем про топовые фишки Яндекс.Музыки, о которых вы не знали.
ПОДПИШИСЬ НА НАС В ЯНДЕКС.ДЗЕН!
Как распознать музыку в Яндекс.Музыке
Скачивать Shazam на смартфон в 2022 году — моветон. Нет, серьезно, практически каждый разработчик внедрил функцию внутрь своих приложений. Яндекс умеет делать это сразу в двух своих приложениях. Первое — фирменный поисковик с Алисой, второе — Яндекс.Музыка. Оба работают весьма неплохо и никогда меня не подводили.
Чтобы распознать музыку в Яндекс.Музыке, вам необходимо:
- Открыть приложение Яндекс.Музыка на своем смартфоне.
- Перейти во вкладку Поиск в верхней части дисплея.
- Свернуть клавиатуру, нажав на иконку внизу.
- Нажать на фиолетовую кнопку Распознать музыку.
- Включить песню, которую вы хотите распознать, и дождаться ответа приложения.
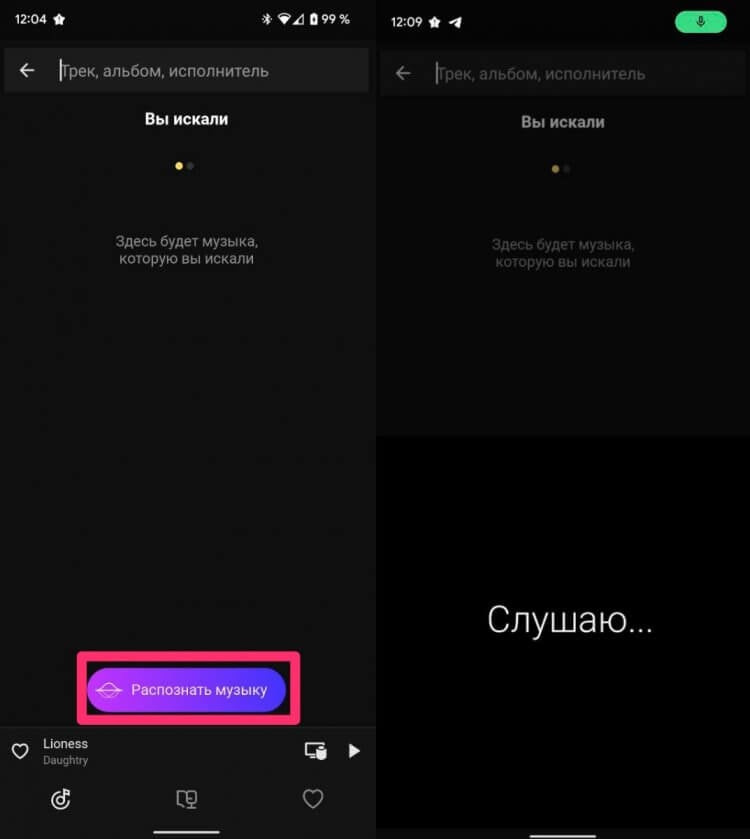
Отказываемся от Шазама, он нам не нужен.
Вообще, мне кажется, что для российского пользователя Яндекс.Музыка будет лучше, чем Шазам. Банально потому, что поиск заточен на русскоязычные композиции. Плюс, Яндекс знает о предпочтениях наших соотечественников лучше за счет своей статистики, а значит и угадывать их проще.
Как настроить эквалайзер в Яндекс.Музыке
С периодичностью раз в неделю в нашем Телеграм-чате появляются сообщения с просьбой рассказать, где найти эквалайзер на Андроиде. Лично мне непонятно, то ли по ту сторону экрана сидят гиганты музыкального искусства, то ли любители зеленого робота настолько привыкли настраивать телефон под себя.
Яндекс.Музыка не имеет своего эквалайзера, зато приложение может отослать вас к эквалайзеру на вашем устройстве:
- Откройте приложение Яндекс.Музыка на своем смартфоне.
- Далее нажмите на сердечко в правом нижнем углу дисплея.
- Тапните на иконку Настроек в верхней правой части.
- Перейдите в пункт Эквалайзер, включите ползунок.
- Выставите нужные вам настройки звука.
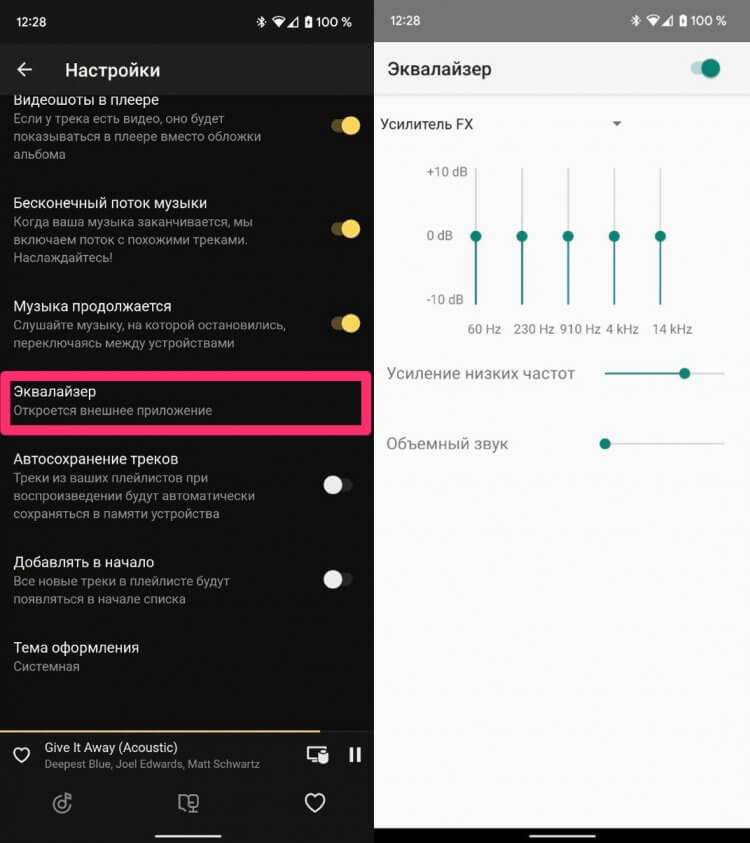
Включайте эквалайзер и настраивайте музыку под свои предпочтения.
Будьте аккуратны! Сверяйтесь после изменения каждых настроек звука с конкретными композициями. Очень неприятно выйдет, если выставите не те параметры, которые хотели бы, а потом пойдете забивать в Гугл запросы типа Почему звук на телефоне стал тише.
Таймер сна Яндекс.Музыка
Знаю, что многие любят засыпать в наушниках. Ранее на эту тему высказывался автор AndroidInsider.ru Иван Герасимов. Коллега рассказывал, опасно ли спать с музыкой и привел несколько примеров адекватного использования гарнитуры перед сном. Рекомендую ознакомиться.
Если вдруг решитесь на такой ответственный шаг, вот вам инструкция по включению таймера сна в Яндекс.Музыке:
- Откройте приложение Яндекс.Музыка на своем смартфоне.
- Далее включите любой трек или плейлист.
- В нижней части найдите иконку таймера и нажмите на нее.
- Установите время, по истечении которого музыка выключится.
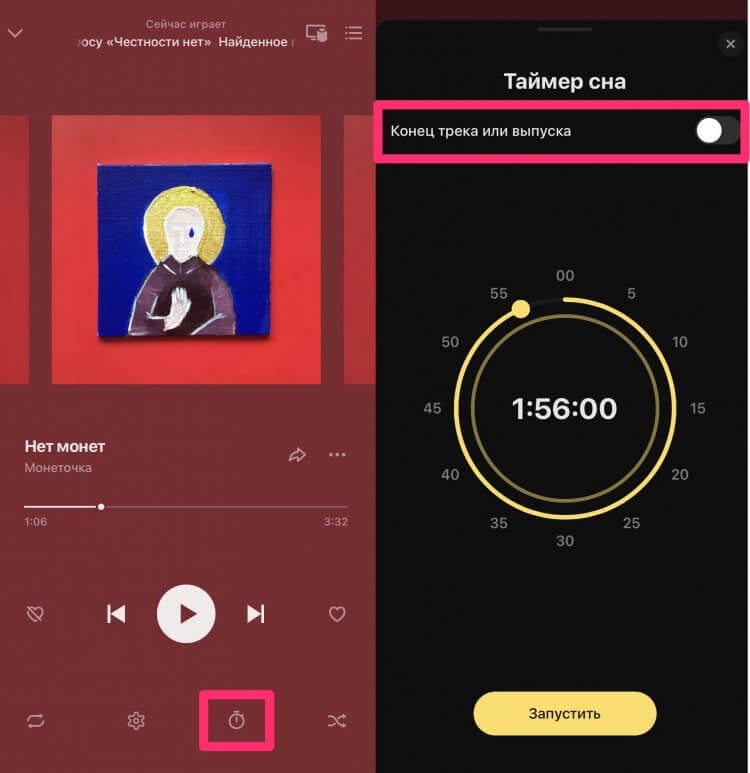
Обратите внимание, что таймер можно запускать больше, чем на 1 час.
Особенно порадовала фишка, с помощью которой можно установить таймер на конец трека или выпуска. Тумблер находится чуть выше самого круга с таймером. С учетом, что в Яндексе есть множество подкастов и книг, такая функция будет полезна многим.
Просмотр статистики исполнителя в Яндекс.Музыке
Для меня большим разочарованием в Яндекс.Музыке стало отсутствие статистики прослушивания треков, которая была в Spotify. Многие, наверное, знают о функции Spotify Wrapped. Обычно там располагались те композиции, которые вы слушали чаще всего в течение года. Яндекс тоже предлагает такую функцию, но один раз в год, в конце декабря. Это своего рода новогодний подарок своим пользователям, так многие сервисы делают.
Однако в Яндекс.Музыке есть другая фича, позволяющая посмотреть статистику исполнителя. Правда, сделать это можно не через приложение, а через сайт музыкального сервиса:
- Откройте сайт Яндекс.Музыки.
- Далее перейдите на страничку любого исполнителя.
- В меню выберите вкладку Инфо, пролистайте чуть ниже.
- Посмотрите статистику по количеству слушателей и лайков.
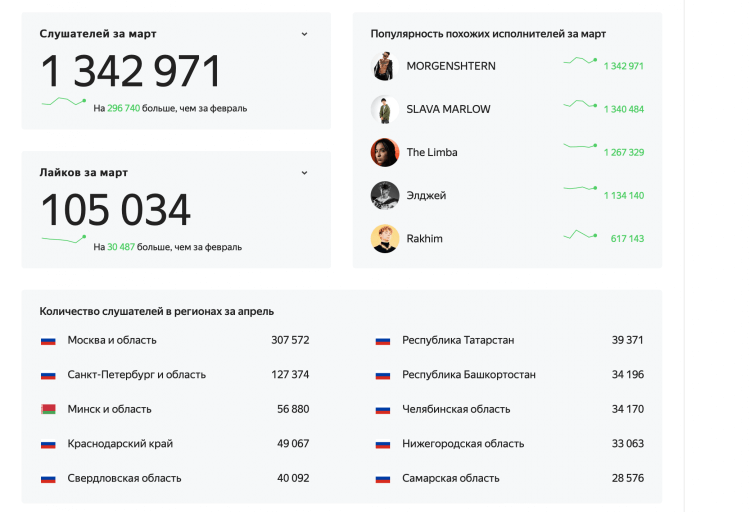
Вот так выглядит статистка исполнителей в Яндекс.Музыке на примере Моргенштерна.
Круто, что Яндекс автоматически составляет рейтинг по прослушиванию в регионах. Я зашел на страничку Моргенштерна и заметил, что в родная для него Республика Башкортостан находится лишь на 7 строчке. Занимательно выходит.
Также на страничке со статистикой высвечиваются все социальные сети исполнителей. Если вы не можете найти кого-то из своих кумиров во ВКонтакте, смело заглядывайте сюда. К слову, на страничке артиста в приложении соцсети тоже высвечиваются (они в самом низу).
Как сбросить рекомендации в Яндекс.Музыке
Бывает оставишь телефон в машине послушать музыку кому-нибудь, а потом по несколько месяцев избавляешься от новых рекомендаций, которые ну очень сильно испортились. Понятно, что алгоритмы Яндекса умные и от одного трека Rammstein не начнут предлагать вам его постоянно, но инструкцию на всякий случай вам оставляю.
Чтобы сбросить рекомендации в Яндекс.Музыке, вам необходимо:
- Перейти на главную страницу сайта Яндекс.Музыки.
- Открыть вкладку Коллекция (расположена наверху).
- Далее кликнуть на иконку настроек под вашем именем.
- Нажать Уточнить напротив пункта Музыкальные предпочтения.
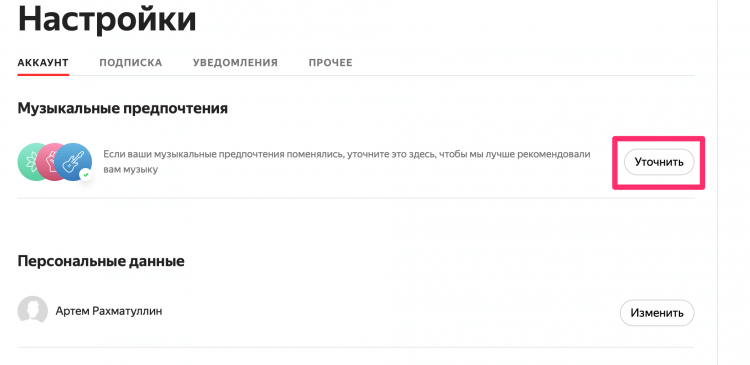
Сбрасывать рекомендации Яндекс.Музыки здесь!
А вы каким музыкальным сервисом пользуетесь нынче? Если не Яндекс.Музыкой, то расскажите, чем она вам не угодила. Обратную связь предлагаю оставить в комментариях под постом или в нашем Телеграм-чате, будет интересно прочесть. Ну и не забывайте подписываться на наш новостной канал, там вы найдете много интересных новостей.
Наши соцсети
Новости, статьи и анонсы публикаций
Как подружить Shazam и Я.Музыку, чтобы быстро добавить распознанный трек в свою коллекцию

В закладки
Лично я постоянно слушаю музыку и часто открываю для себя новых исполнителей и треки с помощью функции распознования песен на своём iPhone. Только вот по умолчанию «зашазамленный» трек можно открыть только в Apple Music.
Чтобы не переходить в приложение «Я.Музыка» и не вбивать название и исполнителя в строку поиска вручную, предлагаю использовать быструю команду, которая все делает за вас. Вам остаётся только добавить трек в свою коллекцию Яндекс музыки.
Как подружить Shazam и Я.Музыку
Эта команда пригодится в первую очередь для тех, кто слушает музыку в приложении Я.Музыка. Соответственно, это приложение должно быть установлено на вашем айфоне. Скачать его бесплатно из App Store можно по этой ссылке.
1. Установите на свой айфон приложение Команды из App Store и загрузите вот эту команду.
2. Запустите распознавание музыки и дождитесь, когда айфон покажет информацию о звучащем треке. Нажмите на всплывающее окно и перейдите на страницу распознанного трека.
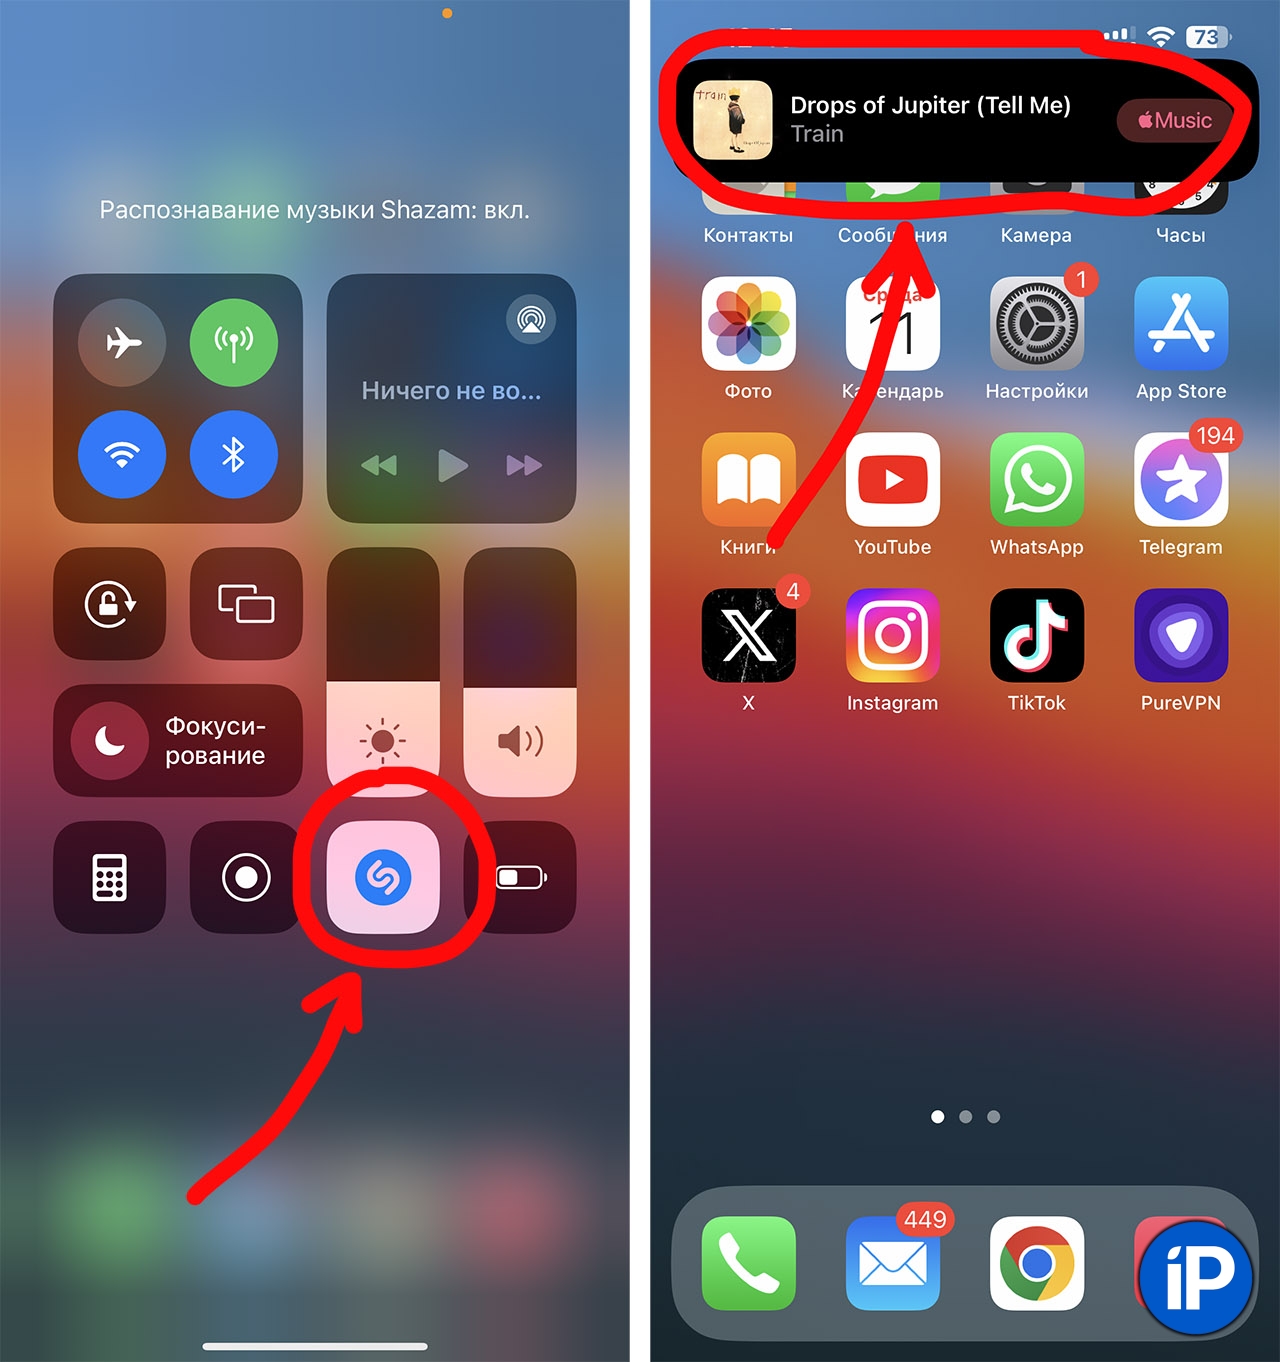
3. Нажмите на пиктограмму «поделиться» в правом верхнем углу.
4. Прокрутите появившееся меню до самого низа и тапните на строчку «Яндекс Музыка».
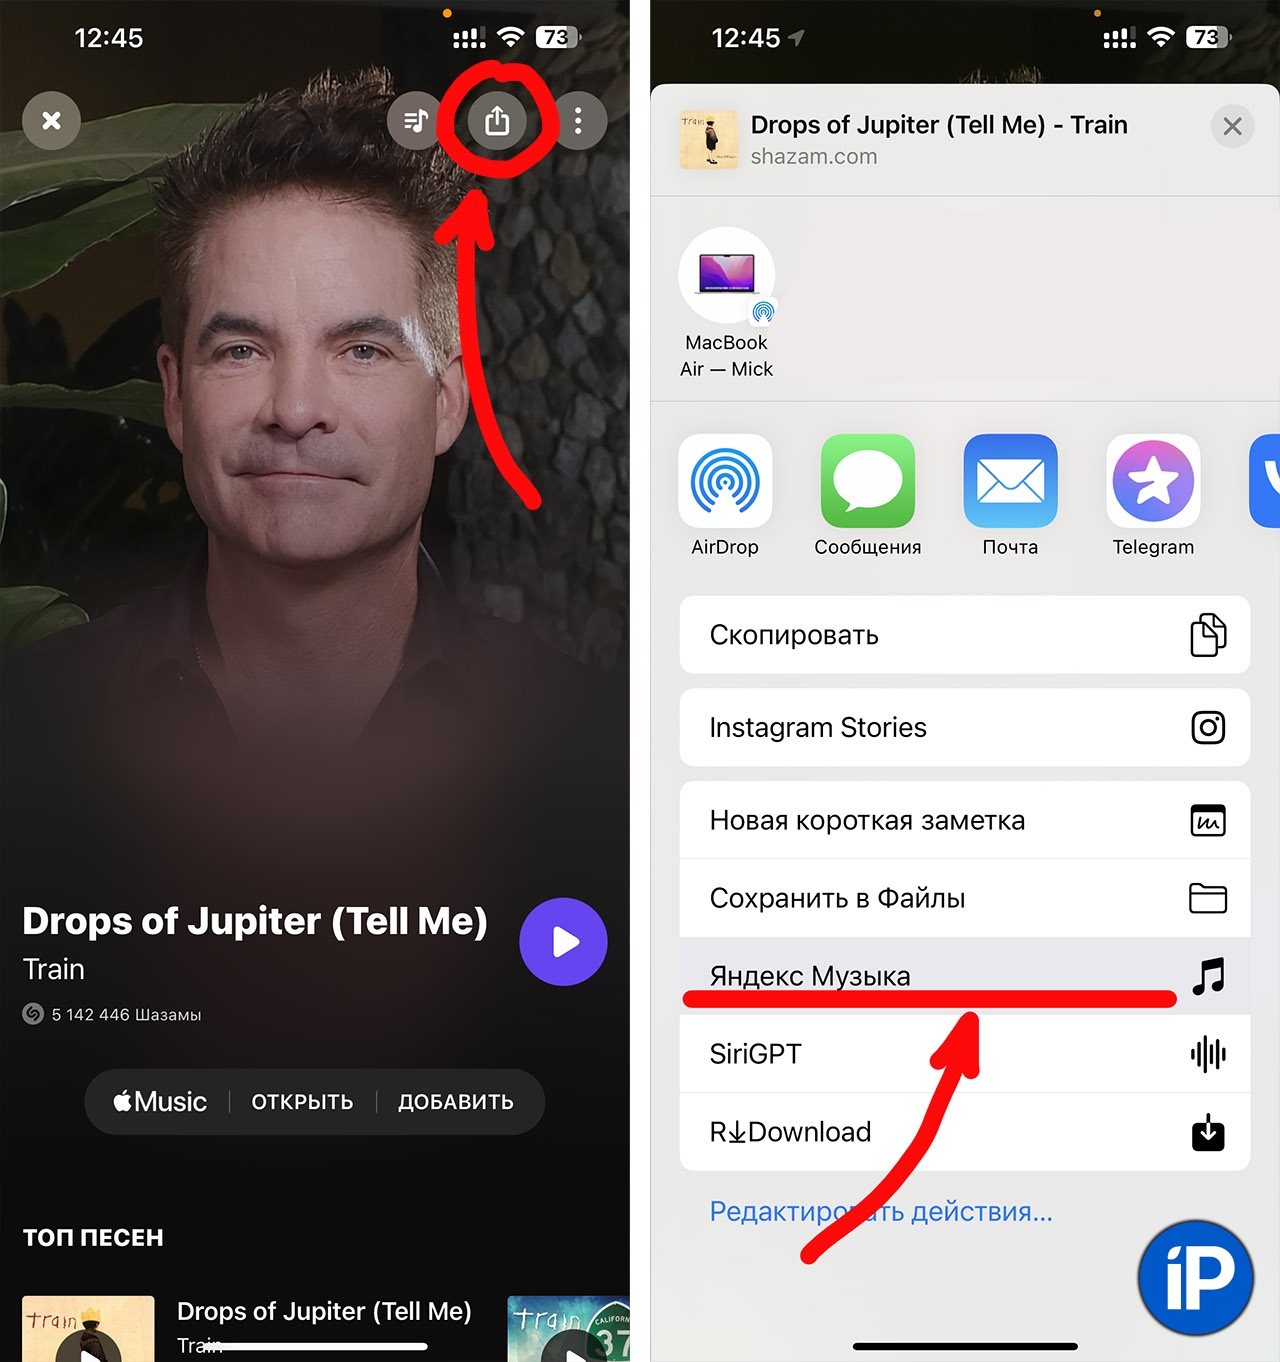
После этого на экране откроется приложение Я.Музыка c уже вписанным в строку поиска и найденным треком, который был только что распознан в Shazam.
Теперь вы с лёгкостью можете «шазамить» треки и быстро добавлять их в свой плейлист в приложении Я.Музыка. Это очень удобно, пользуйтесь.
(24 голосов, общий рейтинг: 4.67 из 5)
�� Хочешь ещё? Читай больше в Telegram
�� Ищешь ответ на вопрос? Приходи на Форум
Лично я постоянно слушаю музыку и часто открываю для себя новых исполнителей и треки с помощью функции распознования песен на своём iPhone. Только вот по умолчанию «зашазамленный» трек можно открыть только в Apple Music. Чтобы не переходить в приложение «Я.Музыка» и не вбивать название и исполнителя в строку поиска вручную, предлагаю использовать быструю команду, которая.
Микк Сид
Пишу обо всём, что интересно и познавательно — гаджеты, события, репортажи. Увлекаюсь игрой на барабанах, меломан со стажем.
Под капотом бота-клиента Яндекс.Музыки
Привет, Хабр! Вновь я с уже второй статьей, затрагивающей API Яндекс.Музыки. Дело запланированное и упоминалось в первой статье.
Руки дошли, дело сделано. Сегодня я расскажу об интересных, на мой взгляд, моментах, которые присутствуют в кодовой базе моего Telegram бота, позиционирующего себя как полноценный клиент я.музыки. Ещё мы затронем API для распознавания музыки от Яндекс.
Перед тем, как приступить к попунктному рассказу реализации той или иной вещи, стоило бы иметь представление о самом боте и его функциональных возможностях.
Видеодемонстрация клиента
В основной части я расскажу про следующее:
- Авторизация в аккаунт через сайт на GitHub Pages (зачем и почему).
- Формат данных, его упаковка и использование в данных для кнопок.
- Роутинг апдейтов, версионность данных, прокидывание контекста в обработчики.
- Сервисы:
- Сервис перезаливки трека в Telegram.
- Сервис «подписок» на получение трека с отправкой статуса о загрузке.
- Наипростейшая и элегантная реализация кэширования запросов.
- Распознавание трека по голосовому сообщению и как это вообще появилось в боте.
- Мелкие заметки.
Если Вас заинтересовал хоть один пункт — добро пожаловать под кат.
Бот работает, как с пользователями, прошедшими авторизацию в свой аккаунт, так и нет. Всё вертится вокруг четырёх основных классов сервиса: альбом, исполнитель, плейлист и трек. Все данные сущности поддерживаются, присутствует постраничный вывод с выбором страницы. Для взаимодействия с ними авторизованный пользователь может воспользоваться своим личным меню, куда входят: умные плейлисты, плейлист «мне нравится» и свои собственные плейлисты. Для неавторизованных пользователей доступен поиск — отправка поискового запроса как обычное сообщение. Теперь просто сухой перечень того, что есть ещё: получение треков и других объектов по прямой ссылке, получение текста песни, возможность поставить лайк/дизлайк треку и исполнителю, просмотр похожих треков, распознавание трека по голосовому сообщению и другое.
Основная часть
1. Авторизация в аккаунт
Изначально бот не планировался для работы без авторизации, поэтому, ещё при проектировании, было решено, как должна происходить авторизация — через свой сайт. Основными аргументами была безопасность и прозрачность. Ни в коем случае не хотелось принимать логины и пароли пользователей через сообщения в открытом виде. А проходить авторизацию с компьютера пользователя — элементарно. Поэтому был написан сайт для авторизации на React’e. Он представляет из себя форму авторизации с редиректом обратно в бота. Кусок с авторизацией и обработки капчи был взят с библиотеки на Python и переписан на JavaScript.
Для авторизации используется полученный OAuth токен, который передаётся обратно в бота через deep linking.
Конечная ссылка для перенаправления выглядит так: t.me/music_yandex_bot?start=
Хотелось как лучше, а доверия у пользователей не было. Авторизацию проходил только каждый десятый пользователь (на момент, когда она была обязательной). Поэтому со следующими обновлениями пришлось объяснить, почему стоит доверять. Все пункты про HTTPS, про исключительно запросы с клиентской стороны и открытый исходный код были опубликованы на самом сайте для авторизации и продублированы в приветствующем сообщении в боте. Стало лучше.
Так же, среди факторов низкой авторизации, оказалась недоступность зеркал для t.me в России и поддержка только пользователей с подпиской (об этом в заметках, 7 пункт).

Первый пункт решился использованием URI (tg://), и в крайнем случае уже ссылка на зеркало (если не сработал автоматический редирект, и кнопка не помогла), а про второй опять же есть в 7 пункте.
2. Формат данных
Для этого бота я решил первый раз использовать NoSQL БД — MongoDB. Разобрался: когда embed документ, когда нет. Понравилось работать с mongoengine. Но я уж никак не хотел хранить все данные кнопок у себя, а у клиента только ID записи в базе. Меня ужасало количество данных, а я ведь хотел взять бесплатный сервер монго с ограничением в 512 мб для хранения данных. Придумывать красивое переиспользование записей, если данные совпадают в нескольких кнопках и заниматься чисткой устаревших — куда сложнее, чем хранить всё в самих кнопках. Проанализировав размер желаемых для хранения данных, сделал вывод, что это легко поместится.
На первых порах я просто использовал JSON, но уж очень быстро от него отказался, когда упёрся в лимит. У Telegram содержимое данных кнопки может быть только не больше 64 байт в UTF-8.
Поэтому, с подсказки друга, я начал смотреть на pack из модуля struct. Так и родились типы запросов, примитивный формат, упаковка и распаковка. Теперь это используется в боте абсолютно везде.
Формат очень прост. Первый байт — тип, второй — версия. Всё остальное является данными для определенного типа. Типы хранятся как Enum, имеют ID, который и является первый байтом. Помимо ID, у каждого типа лежит формат для упаковки и распаковки данных. Например: тип SHOW_TRACK_MENU, у которого формат имеет значение «s?», где «s» — уникальный идентификатор трека, а «?» — имеется ли у трека текст.
У треков используется строковый тип, потому что: во-первых, ID трека может быть конкатенацией ID альбома и ID трека через двоеточие, а во-вторых, может быть UUID. Треки с UUID — самозагруженные треки, доступные только пользователю, который их загрузил.
Так как данные не всегда соответствуют формату, например, тот же ID трека может быть представлен просто числом, то перед упаковкой надо скастовать его в тип под формат. В данном случае s. Поэтому в классе присутствует метод, нормализующий переданные данные для упаковки, чтобы не делать этого самому при передаче в конструктор.
Строки являются самодостаточными и способны указать свою длину при упаковке и учесть эту длину при распаковке.
Поддержка старых версий не планировалась, поэтому при несоответствии версий выбрасывается исключение. При обработке апдейтов, о которых я расскажу в следующем пункте, вызывается необходимая логика.
Так как Telegram ест исключительно UTF-8, то упакованные данные кодируются в base85. Да, я теряю тут скорость и экономлю самую малость в размере, не используя base64, но, учитывая малые данные, считаю использование base85 уместным.
Исходный код. Файл callback_data.py
import struct import base64 from ext.query_types import QueryType class BadDataVersion(Exception): pass class CallbackData: ACTUAL_VERSION = 7 BASE_FORMAT = ' Type: Version: Data: ' def _normalize_data_to_format(self, data, bytes_object=False): normalized_data = data.copy() for i, c in enumerate(self.type.format): cast = str if c.lower() in 'bhilqn': cast = int elif c in 'efd': cast = float elif c == '?': cast = bool casted = cast(data[i]) if bytes_object and cast == str: casted = casted.encode('utf-8') normalized_data[i] = casted return normalized_data @staticmethod def decode_type(callback_data): decoded = base64.b85decode(callback_data.encode('utf-8')) type_, version = struct.unpack(CallbackData.BASE_FORMAT, decoded[:2]) if CallbackData.ACTUAL_VERSION != version: raise BadDataVersion() return QueryType(type_), version, decoded @classmethod def decode(cls, type_, version, decoded): start, data = 2, [] if start < len(decoded): format_iter = iter(type_.format) while True: if start >= len(decoded): break format_ = next(format_iter, type_.format[-1]) decode_str = format_ in 'ps' if decode_str: # struct.calcsize('b') = 1 length = list(struct.unpack('b', decoded[start: start + 1]))[0] start += 1 format_ = f'' step = struct.calcsize(format_) unpacked = list(struct.unpack(f'', decoded[start: start + step])) if decode_str: unpacked[0] = unpacked[0].decode('UTF-8') data += unpacked start += step return cls(type_, data if data else None, version) def encode(self): encode = struct.pack(self.BASE_FORMAT, self.type.value, self.version) if self.data is not None: format_iter = iter(self.type.format) normalized_data = self._normalize_data_to_format(self.data, bytes_object=True) for data in normalized_data: format_ = next(format_iter, self.type.format[-1]) if format_ in 'ps': # в два пака чтобы не заботиться о порядке. Формат 'b' потому что # из-за ограней телеги все равно больше нельзя, да и строк > 36 нет encode += struct.pack('b', len(data)) encode += struct.pack(f'', data) else: encode += struct.pack(f'', data) return base64.b85encode(encode).decode('utf-8') 3. Роутинг апдейтов и контекст
В проекте используется библиотека python-telegram-bot для работы с Telegram Bot API. В ней уже присутствует система регистраций обработчиков на определенные типы пришедших апдейтов, фильтры по регулярным выражениям, командам и так далее. Но, учитывая мой собственный формат данных и свои типы, пришлось унаследоваться от TelegramHandler и реализовать свой Handler.
В каждый обработчик через аргументы передаётся апдейт и контекст. В данном случае контекст у меня свой и именно в Handler’e идёт его формирование, а это: получение и/или добавление пользователя в базу, проверка актуальности токена для получения доступа к музыке, инициализация клиента Яндекс.Музыки в зависимости от статуса авторизации и наличии подписки.
Далее от моего Handler’a идут более специфичные обработчики, например, CallbackQueryHandler. С помощью него происходит регистрация обработчика для определенного типа апдейта (моего типа, с форматом данных). Для проверки, подходит ли данный апдейт под текущий обработчик, распаковка происходит не всех данных, а только первых двух байт. На этом этапе и сверяется необходимость запуска коллбека. Только если запуск коллбека необходим — происходит полная распаковка данных и их передача как kwargs в конечный обработчик. Тут же и происходит отправка аналитических данных на ChatBase.
Регистрация происходит последовательно, и приоритет выше у того, кто будет зарегистрирован раньше (собственно, как и в Django роутинге, да и в других проектах). Поэтому регистрация обработчика на устаревшую версию идёт первым среди обработчиков CallBackQuery.
Логика обработки устаревшей версии проста — сообщить об этом пользователю и прислать обновлённые данные, если возможно.
4. Сервисы
Все сервисы инициализируются при запуске бота в одном управляющем классе, который потом повсеместно используется в любом месте бота (DJ).
У каждого сервиса свой ThreadPoolExecutor с определённым количеством воркеров, в который сабмитятся задачи.
Перезаливка трека в Telegram
На данный момент этот сервис не переписан на User Bot’a для обхода ограничения на размер загружаемого файла в Telegram. Как оказалось, в Яндекс.Музыке есть файлы размером больше 50 мб — подкасты.
Сервис проверяет размер файла и, в случае превышения, — кидает алерт пользователю. Благодаря системе кэширования, описанной в пункте 5, тут происходит проверка наличия и получение текста песни. Кэшируются также и треки. Хэш файла хранится в базе. При наличии такового — идёт отправка аудио с известным кэшем.
При отсутствии файла в базе, происходит прямое получение ссылки с Яндекс.Музыки. Хотя в данный момент возможности менять настройки качества у пользователей нет, но всем выставлены стандартные значения. Происходит поиск файла по битрейту и кодеку из настроек пользователя.
Файл и его обложка загружаются как tempfile.TemporaryFile(), после чего загружаются в Telegram. Стоит отметить, что TG не всегда корректно распознает длительность трека, а про исполнителя и название я вообще молчу. Поэтому эти данные берутся у Яндекса, благо, есть возможность их передать в телегу.
При отправке аудиофайла данным сервисом вызывается finished_callback(), сигнализирующий сервису по подпискам о конце загрузки.
Сервис «подписок» на получение треков и отправка статуса загрузки
Треки загружаются не моментально. Возможен случай, когда один и тот же трек запросило несколько пользователей. В данном случае пользователь, который запросил трек первым, является инициатором и владельцем трека. При перезаливке больше чем в секунду, начинается отправка статуса о загрузке: “Пользователь отправляет голосовое сообщение”. Остальные пользователи, которые запросили тот же трек, являются обычными подписчиками. Им, так же как и владельцу, происходит отправка статуса загрузки раз в ~4 секунды, чтобы сообщение не прерывалось (статус висит 5 секунд). Как только загрузка трека для владельца завершилась, вызывается finished_callback() из сервиса выше. После чего все подписчики удаляются из рассылки статуса и получают загруженный трек.
В архитектурном решении владелец трека также является подписчиком, но с определённой отметкой, так как способы отправки трека отличаются.
5. Кэширование запросов
Как мы помним из моей прошлой статьи, запросы в API Яндекс.Музыки очень тяжелые. Список треков может быть и 3, и 5 мб. Более того, запросов просто много. С каждой обработкой апдейта на Яндекс отправляется минимум 2 запроса: на инициализацию клиента и на определенное действие. Местами, для сбора достаточного количества информации (например для плейлиста), необходимо сделать запрос на получение плейлиста, на получение его треков, на информации с лендинга (если это умный плейлист), а еще не забываем про инициализацию клиента. В общем, тихий ужас по количеству запросов.
Хотелось чего-то очень универсального, а не делать какие-то хранилища для определенных объектов, тех же клиентов.
Так как библиотека позволяет указать свой собственный экземпляр для выполнения запросов, поверх requests, то этим я и воспользовался.
Суть проста. Сам класс кэша является синглтоном. У него есть всего два параметра: время жизни кэша, размер. При выполнении запроса вызывается враппер. Он и переопределён. Проверка наличия в кэше происходит по хешу замороженных аргов и кваргов. У кэша есть время добавления. При проверке необходимости обновления данных либо достаются данные с LimitedSizeDict, либо делается реальный запрос и добавление в кэш.
Некоторые запросы нельзя кэшировать, например, установку лайка/дизлайка. Если пользователь прожмёт следующую последовательность: лайк, дизлайк, лайк, то в конечном итоге лайк поставлен не будет. Для таких случаев, при отправке запроса, нужно передать аргумент use_cache со значением равным False. Собственно, это единственное место, где кэш не используется.
Благодаря этому я делаю максимально жирные запросы, чтобы они были закэшированы. Не пытаюсь разбить на мелкие и нужные только для текущей страницы. Я беру сразу всё, а при переходе между страницами имею огромную скорость переключения (в сравнении со старым подходом).
Как по мне, то класс кэшируемого запроса получился красиво и элементарно был интегрирован.
Исходный код
import copy import time from typing import Union from collections import OrderedDict import requests from yandex_music.utils.request import Request as YandexMusicRequest class LimitedSizeDict(OrderedDict): def __init__(self, *args, **kwargs): self.size_limit = kwargs.pop("size_limit", None) OrderedDict.__init__(self, *args, **kwargs) self._check_size_limit() def __setitem__(self, key, value): OrderedDict.__setitem__(self, key, value) self._check_size_limit() def _check_size_limit(self): if self.size_limit is not None: while len(self) > self.size_limit: self.popitem(last=False) class CachedItem: def __init__(self, response: requests.Response): self.timestamp = time.time() self.response = response class Cache: __singleton: 'Cache' = None def __init__(self, lifetime: Union[str, int], size: Union[str, int]): Cache.__singleton = self self.lifetime = int(lifetime) * 60 self.size = int(size) self.storage: LimitedSizeDict = LimitedSizeDict(size_limit=int(size)) def get(self, *args, **kwargs): hash_ = Cache.get_hash(*args, **kwargs) return self.storage[hash_].response def update(self, response: requests.Response, *args, **kwargs): hash_ = Cache.get_hash(*args, **kwargs) self.storage.update() def need_to_fetch(self, *args, **kwargs): hash_ = Cache.get_hash(*args, **kwargs) cached_item = self.storage.get(hash_) if not cached_item: return True if time.time() - cached_item.timestamp > self.lifetime: return True return False @classmethod def get_instance(cls) -> 'Cache': if cls.__singleton is not None: return cls.__singleton else: raise RuntimeError(f' not initialized') @staticmethod def freeze_dict(d: dict) -> Union[frozenset, tuple, dict]: if isinstance(d, dict): return frozenset((key, Cache.freeze_dict(value)) for key, value in d.items()) elif isinstance(d, list): return tuple(Cache.freeze_dict(value) for value in d) return d @staticmethod def get_hash(*args, **kwargs): return hash((args, Cache.freeze_dict(kwargs))) class Request(YandexMusicRequest): def _request_wrapper(self, *args, **kwargs): use_cache = kwargs.get('use_cache', True) if 'use_cache' in kwargs: kwargs.pop('use_cache') if not use_cache: response = super()._request_wrapper(*args, **copy.deepcopy(kwargs)) elif use_cache and Cache.get_instance().need_to_fetch(*args, **kwargs): response = super()._request_wrapper(*args, **copy.deepcopy(kwargs)) Cache.get_instance().update(response, *args, **kwargs) else: response = Cache.get_instance().get(*args, **kwargs) return response 6. Распознавание трека по голосовому сообщению
В начале и мысли не было добавлять это в бота, но случилась интересная ситуация. У бота есть чат (он указан в описании к боту). Спустя некоторое время я заметил, что люди заходят в него и отправляют голосовые сообщения с музыкой. Вначале я подумал, что это новый вид спама такой, ботоводит кто-то и прикалывается. Но, когда таких людей было уже под 10 и все делали то же самое, мой друг (тот же, что подсказал за struct), предположил, что пользователи вбивают в поиск “Яндекс.Музыка” в ожидании официального бота для распознавания музыки от Яндекса, видят там чатик и отправляют в него голосовые на полном серьёзе! Это было просто гениальное и верное предположение. Тогда я в шутку сказал, что пора сделать распознавание и добавлять бота в чат. В шутку… Спустя некоторое время это и было сделано!
Теперь по поводу API. В последнее время в Яндексе всё чаще используют вебсокеты. Встретил их использование в управлении я.модулем и я.станцией. Сервис по распознаванию музыки тоже работает на нём. Я накидал минимальное рабочее решение у себя в боте, но в библиотеку реализацию не добавлял.
WS находится по следующему адресу: wss://voiceservices.yandex.net/uni.ws
Нам необходимо всего два сообщения — авторизация и запрос на recognize.
Сам Яндекс, в своём официальном приложении, отправляет короткие файлы по секунде-три. В ответ можно получить необходимость прислать больше данных или результат — нашел или нет. Если результат найден, то вернётся ID трека.
Отправляются .ogg файлы с ENCODER=SpeechKit Mobile SDK v3.28.0. Я не проверял то, как оно работает с другими encoder’ами, просто изменяю его в файле, записанном Telegram’ом.
При реверсе с вебсокетом иногда происходила магия. Иногда не находило трек, но когда менял язык в сообщении с запросом на распознавание — находило. Или вначале находило, а потом переставало, хотя файл тот же. Я подумал, что язык трека устанавливается их SpeechKit’ом на клиенте. Не имея такой возможности сделать у себя, я делаю перебор языков.
Моя сделанная на коленке реализация распознавания войсов по голосовым сообщениям с Telegram
import uuid import lomond def get_auth_data(): return < "event": < "header": < "messageId": str(uuid.uuid4()), "name": "SynchronizeState", "namespace": "System" >, "payload": < "accept_invalid_auth": True, "auth_token": "5983ba91-339e-443c-8452-390fe7d9d308", "uuid": str(uuid.uuid4()).replace('-', ''), >> > def get_asr_data(): return < "event": < "header": < "messageId": str(uuid.uuid4()), "name": "Recognize", "namespace": "ASR", "streamId": 1 >, "payload": < "advancedASROptions": < "manual_punctuation": False, "partial_results": False >, "disableAntimatNormalizer": False, "format": "audio/opus", "music_request2": < "headers": < "Content-Type": "audio/opus" >>, "punctuation": False, "tags": "PASS_AUDIO;", "topic": "queries" > > > class Recognition: URI = 'wss://voiceservices.yandex.net/uni.ws' LANGS = ['', 'ru-RU', 'en-US'] POLL_DELAY = 0.3 def __init__(self, binary_data, status_msg): self.status_msg = status_msg self.websocket = lomond.WebSocket(self.URI) self.chunks = self.get_chunks_and_replace_encoder(binary_data) def get_track_id(self): for lang in Recognition.LANGS: asr_data = get_asr_data() if lang: asr_data['event']['payload'].update() self.status_msg.edit_text(f'Попытка распознать музыку на языке . ') else: self.status_msg.edit_text(f'Попытка распознать музыку без привязки к языку. ') for msg in self.websocket.connect(poll=self.POLL_DELAY): if msg.name == 'ready': self.websocket.send_json(get_auth_data()) self.websocket.send_json(asr_data) for chunk in self.chunks: self.websocket.send_binary(chunk) if msg.name == 'text': response = msg.json.get('directive') if self.is_valid_response(response): self.websocket.close() return self.parse_track_id(response) elif self.is_fatal_error(response): self.websocket.close() break def is_valid_response(self, response): if response.get('header', <>).get('name') == 'MusicResult' and \ response.get('payload', <>).get('result') == 'success': self.status_msg.edit_text(f'Трек найден, начинаем загрузку!') return True return False @staticmethod def is_fatal_error(response): if response.get('header', <>).get('name') == 'MusicResult' and \ response.get('payload', <>).get('result') == 'music': return False return True @staticmethod def parse_track_id(response): return response['payload']['data']['match']['id'] @staticmethod def get_chunks_and_replace_encoder(binary_data): chunks = [] for chunk in binary_data.split(b'OggS')[1:]: if b'OpusTags' in chunk: pos = chunk.index(b'OpusTags') + 12 size = len(chunk) chunk = chunk[:pos] + b'#\x00\x00\x00\x00ENCODER=SpeechKit Mobile SDK v3.28.0' chunk += b"\x00" * (size - len(chunk)) chunks.append(b'\x00\x00\x00\x01OggS' + chunk) return chunks Хоть я и занимался ревёрсом сам, под конец мне скинули уже готовый.
7. Мелкие заметки
Изначально ботом пользоваться могли только пользователи с подпиской по причине того, что сервис можно использовать в ограниченном количестве стран (без подписки), а сервер с ботом находится в Европе. Проблема решена использованием прокси, для выполнения запросов от пользователей без подписки. Сервер с прокси находится в Москве.
Выбор страниц есть, но он ограничен 100 (нельзя больше кнопок добавить, ограничение Telegram). В некоторых общих запросах страниц куда больше.
В поиске у Яндекса захардкожено количество элементов на странице. Сколько треков, сколько плейлистов. Иногда это даже не соответствует количеству отображаемых на фронте данных. Изменение страницы есть, количество элементов плавает. Поэтому в боте это так же скачет, что не очень красиво. А объединять их пагинатор со своим — как-то такое. В других местах, где есть возможность запросить определённое количество элементов на страницу, всё идеально. Голосовое сообщение после реализации поиска в боте — t.me/MarshalC/416.
При форварде аудио в Telegram’e теряется автор и присваивается тому, кто сделал форвард. Поэтому все треки отправляются с подписью юзернейма бота.
Голосовое сообщения со всем, с чем встретился после реализациии радио в библиотеке — t.me/MarshalC/422 (о цепочке треков, проходу по ней с отправкой кучи фидбека, batch_id).
Заключение
Несмотря на то, что это очередная статья про Telegram бота, вы дочитали аж до сюда, скорее всего потому, что вас заинтересовал один из пунктов в кате и это замечательно, спасибо Вам большое!
К сожалению, я не открыл исходный код бота целиком (потому что местами надо порефакторить). Многое описано в этой статье, но некоторые аспекты, например, с виртуальными клавиатурами и их генерацией не затронуты. По большей части то, чего нет в статье — просто работа с моей библиотекой, ничего интересного.
Классы, вокруг которых всё вертится, я показал в том виде, в котором они сейчас. Я допускаю наличие там багов, но это всё работает продолжительное время. Местами мне нравится свой код, местами нет — и это нормально. Не забываем, что работа с WS для распознавания — решение на коленке. Готов почитать аргументированную критику в комментариях.
Хоть бот и планировался ещё тогда, когда я начинал писать библиотеку, потом я от этой идеи открестился, но, как видно, вернулся (было скучно).
Яндекс.Музыка Бот — проект, доказывающий пригодность использования библиотеки для работы с API в проектах.
Большое спасибо Маме, Яне, Сане, Славе. Кому за вычитку ошибок, кому за подсказки, без которых некоторых пунктов в этой статье могло и не быть, а кому и просто за оценку статьи перед публикацией. Артуру за пикчи для статьи, Lyod’у за логотип.
P.S. У меня сейчас остро стоит вопрос с распределением после учёбы. Если Вы готовы сделать на меня вызов — сообщите куда отправить CV, прособеседуйте меня, пожалуйста. Все мои контакты есть в профиле. Сроки горят, я надеюсь на Вас. По закону проходить отработку могу только в Республике Беларусь.
P.S.S. Это была вторая статья из трёх, но я без малейшего понятия успею ли сделать ещё один проект на эту тему и нужен ли он. Публично раскрою его тему — кроссплатформенный клиент Яндекс.Музыки.
Где в яндекс музыке распознавание песни
Будь в курсе последних новостей из мира гаджетов и технологий
iGuides для смартфонов Apple
Приложения «Яндекс.Музыки» научились распознавать песни. Как использовать новую функцию

Денис Черкашин — 18 июля 2018, 18:31
Мобильные приложения «Яндекс.Музыки» для iOS и Android получили функцию распознавания композиций. Она работает в режиме реального времени и только при подключении к интернету — мобильному или Wi-Fi.
Чтобы найти песню, которая прямо сейчас играет в магазине, кафе или спортзале, запустите «Яндекс.Музыку», перейдите на вкладку «Поиск» и нажмите на значок микрофона. Приложение прослушает короткий отрывок, и, если распознает трек, напишет название композиции и имя исполнителя. Все песни, найденные с помощью этой функции, появятся в плейлисте «Распознано».
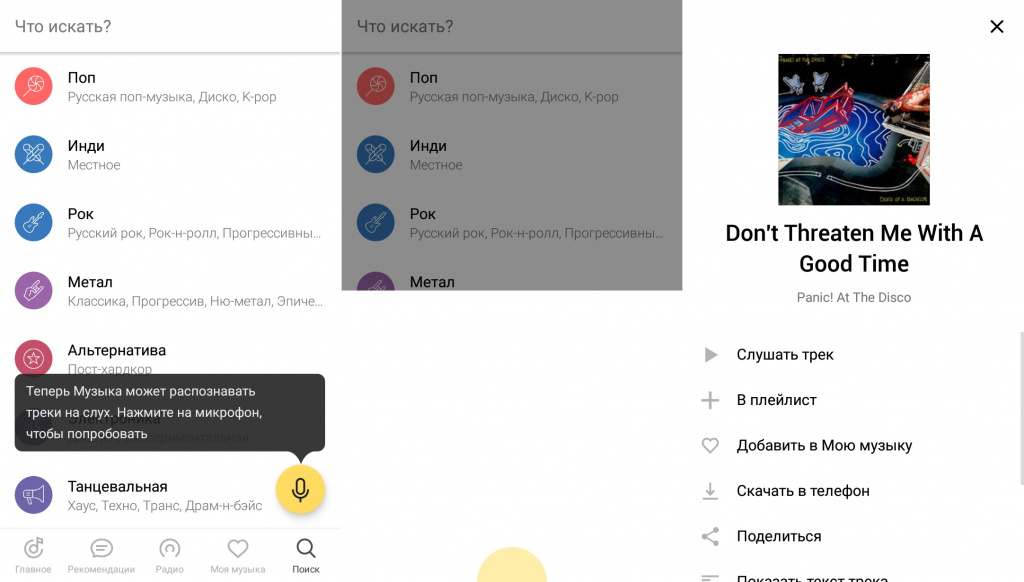
Нововведение доступно для любых устройств на iOS и Android и доступно с сегодняшнего дня в соответствующих магазинах приложений.