Как включить cuda на видеокарте nvidia
Внимание, обнаружена ошибка
Гости не имеют доступа для просмотра статей из данного раздела.
Популярное
3 способа получения пассивного дохода в криптовалюте
Авторизация
Последние статьи
Как включить автообновление в Виндовс 10
«Расположение недоступно. Отказано в доступе» в Windows 10
Ошибка Центра обновления в Windows 11
Как обновить Windows 11 Home до Pro
Как отключить брандмауэр в Виндовс 10
Как открыть дисковод на компьютере без кнопки
Чем открыть HEIC в Windows 7
Пробная страница печати напечатана неправильно в Windows 10
Аппаратное ускорение NVIDIA
Включение конвертации с использованием NVIDIA GPU
С включенной опцией ваша видеокарта NVIDIA будет использована при конвертации видео с кодеками H.264 и MPEG-2. Видео будут обрабатываться до 50% быстрее.
Использование видеокарты вместо процессора позволяет вам оставлять процессор для других задач и свободно и использовать компьютер для других целей во время конвертации.
Эта опция доступна, только если ваш компьютер оборудован видеокартой NVIDIA с поддержкой технологии CUDA™ или NVENC™.
В списке форматов для конвертацией ищите профили со значком NVIDIA NVENC или NVIDIA CUDA, в зависимости от технологии ускорения, которую поддерживает ваша видеокарта.

Совместимые модели видеокарт
Ускорение NVIDIA поддерживают видеокарты серий GeForce, Tesla и Quadro. Вы можете ознакомиться с полным списком на официальном сайте NVIDIA: Видеокарты с поддержкой CUDA | Видеокарты с поддержкой NVENC .
Примечание: мобильные видеокарты не поддерживают ускорение NVIDIA.
Устранение проблем
Как узнать, какой графический процессор у моего компьютера?
Кликните правой кнопкой мыши по рабочему столу и в появившемся меню выберите Разрешение дисплея.
В появившемся окне нажмите Расширенные настройки. Откроются параметры GPU.
В разделе Вид адаптера вы можете найти модель вашего GPU’s.
Невозможно включить ускорение NVIDIA в настройках
Если функция ускорения NVIDIA недоступна в настройка, попробуйте обновить драйверы вашей видеокарты..
CUDA и удалённый GPU
CUDA всем хороша, пока под рукой есть видеокарта от Nvidia. Но что делать, когда на любимом ноутбуке нет Nvidia видеокарты? Или нужно вести разработку в виртуальной машине?
Я постараюсь рассмотреть в этой статье такое решение, как фреймворк rCUDA (Remote CUDA), который поможет, когда Nvidia видеокарта есть, но установлена не в той машине, на которой предполагается запуск CUDA приложений. Тем, кому это интересно, добро пожаловать под кат.
rCUDA (Remote CUDA) — фреймворк, реализующий CUDA API, позволяющий использовать удалённую видеокарту. Находится в работоспособной бета-версии, доступен только под Linux. Основная цель rCUDA — полная совместимость с CUDA API, вам не нужно никак модифицировать свой код, достаточно задать специальные переменные среды.
Что такое rCUDA
rCUDA (Remote CUDA) — фреймворк, реализующий CUDA API, позволяющий использовать для CUDA вычислений видеокарту, расположенную на удалённой машине, не внося никаких изменений в ваш код. Разработан в политехническом университете Валенсии (rcuda-team).
Ограничения
На данный момент поддерживаются только GNU/Linux системы, однако разработчики обещают поддержку Windows в будущем. Текущая версия rCUDA, 18.03beta, совместима с CUDA 5-8, то есть CUDA 9 не поддерживается. Разработчиками заявлена полная совместимость с CUDA API, за исключением графики.
Возможные сценарии использования
- Запуск CUDA приложений в виртуальной машине тогда, когда проброс видеокарты неудобен или невозможен, например, когда видеокарта занята хостом, или когда виртуальных машин больше одной.
- Ноутбук без дискретной видеокарты.
- Желание использовать несколько видеокарт (кластеризация). Теоретически, можно использовать все имеющиеся в команде видеокарты, в том числе совместо.
Краткая инструкция
Тестовая конфигурация
Тестирование проводилось на следующей конфигурации:
Сервер:
Ubuntu 16.04, GeForce GTX 660
Клиент:
Виртуальная машина с Ubuntu 16.04 на ноутбуке без дискретной видеокарты.
Получение rCUDA
Cамый сложный этап. К сожалению, на данный момент единственный способ получить свой экземпляр этого фреймворка — заполнить соответствующую форму запроса на официальном сайте. Впрочем, разработчики обещают отвечать в течение 1-2 дней. В моём случае мне прислали дистрибутив в тот же день.
Установка CUDA
Для начала необходимо установить CUDA Toolkit на сервере и клиенте (даже если на клиенте нет nvidia видеокарты). Для этого можно скачать его с официального сайта или использовать репозиторий. Главное, использовать версию не выше 8. В данном примере используется установщик .run с оффициального сайта.
chmod +x cuda_8.0.61_375.26_linux.run ./cuda_8.0.61_375.26_linux.runВажно! На клиенте следует отказаться от установки nvidia драйвера. По умолчанию CUDA Toolkit будет доступен по адресу /usr/local/cuda/. Установите CUDA Samples, они понадобятся.
Установка rCUDA
Распакуем полученный от разработчиков архив в нашу домашнюю директорию на сервере и на клиенте.
tar -xvf rCUDA*.tgz -C ~/ mv ~/rCUDA* ~/rCUDAПроделать эти действия нужно как на сервере, так и на клиенте.
Запуск демона rCUDA на сервере
export PATH=$PATH/usr/local/cuda/bin export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:/usr/local/cuda/lib64:/home//rCUDA/lib/cudnn cd ~/rCUDA/bin ./rCUDAd Замените < XXX>на имя вашего пользователя. Используйте ./rCUDAd -iv, если хотите видеть подробный вывод.
Настройка клиента
Откроем на клиенте терминал, в котором в дальнейшем будем запускать CUDA код. На стороне клиента нам необходимо «подменить» стандартные библиотеки CUDA на библиотеки rCUDA, для чего добавим соответствующие пути в переменную среды LD_LIBRARY_PATH. Также нам необходимо указать количество серверов и их адреса (в моём примере он будет один).
export PATH=$PATH/usr/local/cuda/bin export LD_LIBRARY_PATH=/home//rCUDA/lib/:$LD_LIBRARY_PATH export RCUDA_DEVICE_COUNT=1 # укажем количество видеокарт (серверов), их может быть несколько export RCUDA_DEVICE_0=:0 # укажем адрес первого сервераСборка и запуск
Попробуем собрать и запустить несколько примеров.
Пример 1
Начнём с простого, с deviceQuery — примера, который просто выведет нам параметры CUDA совместимого устройства, то есть в нашем случае удалённого GTX660.
cd /NVIDIA_CUDA-8.0_Samples/1_Utilities/deviceQuery make EXTRA_NVCCFLAGS=--cudart=sharedВажно! Без EXTRA_NVCCFLAGS=—cudart=shared чуда не получится
Замените на путь, который вы указали для CUDA Samples при установке CUDA.
Запустим собранный пример:
./deviceQueryЕсли вы всё сделали правильно, результат будет примерно таким:
Результат
./deviceQuery Starting. CUDA Device Query (Runtime API) version (CUDART static linking) Detected 1 CUDA Capable device(s) Device 0: "GeForce GTX 660" CUDA Driver Version / Runtime Version 9.0 / 8.0 CUDA Capability Major/Minor version number: 3.0 Total amount of global memory: 1994 MBytes (2090991616 bytes) ( 5) Multiprocessors, (192) CUDA Cores/MP: 960 CUDA Cores GPU Max Clock rate: 1072 MHz (1.07 GHz) Memory Clock rate: 3004 Mhz Memory Bus Width: 192-bit L2 Cache Size: 393216 bytes Maximum Texture Dimension Size (x,y,z) 1D=(65536), 2D=(65536, 65536), 3D=(4096, 4096, 4096) Maximum Layered 1D Texture Size, (num) layers 1D=(16384), 2048 layers Maximum Layered 2D Texture Size, (num) layers 2D=(16384, 16384), 2048 layers Total amount of constant memory: 65536 bytes Total amount of shared memory per block: 49152 bytes Total number of registers available per block: 65536 Warp size: 32 Maximum number of threads per multiprocessor: 2048 Maximum number of threads per block: 1024 Max dimension size of a thread block (x,y,z): (1024, 1024, 64) Max dimension size of a grid size (x,y,z): (2147483647, 65535, 65535) Maximum memory pitch: 2147483647 bytes Texture alignment: 512 bytes Concurrent copy and kernel execution: Yes with 1 copy engine(s) Run time limit on kernels: Yes Integrated GPU sharing Host Memory: No Support host page-locked memory mapping: Yes Alignment requirement for Surfaces: Yes Device has ECC support: Disabled Device supports Unified Addressing (UVA): Yes Device PCI Domain ID / Bus ID / location ID: 0 / 1 / 0 Compute Mode: < Default (multiple host threads can use ::cudaSetDevice() with device simultaneously) >deviceQuery, CUDA Driver = CUDART, CUDA Driver Version = 9.0, CUDA Runtime Version = 8.0, NumDevs = 1, Device0 = GeForce GTX 660 Result = PASSСамое главное, что мы должны увидеть:
Device0 = GeForce GTX 660
Result = PASS
Отлично! Нам удалось собрать и запустить CUDA приложение на машине без дискретной видеокарты, использовав для этого видеокарту, установленную на удалённом сервере.
Важно! Если вывод приложения начинается со строк вида:
mlock error: Cannot allocate memory rCUDA warning: 1007.461 mlock error: Cannot allocate memory значит необходимо добавить на сервере и на клиенте в файл «/etc/security/limits.conf» следующие строки:
* hard memlock unlimited * soft memlock unlimited Таким образом, вы разрешите всем пользователям (*) неограниченное (unlimited) блокирование памяти (memlock). Еще лучше будет заменить * на нужного пользователя, а вместо unlimited подобрать менее жирные права.
Пример 2
Теперь попробуем что-то поинтереснее. Протестируем реализацию скалярного произведения векторов с использованием разделяемой памяти и синхронизации («Технология CUDA в примерах» Сандерс Дж. Кэндрот Э. 5.3.1).
В данном примере мы рассчитаем скалярное произведение двух векторов размерностью 33 * 1024, сравнивая ответ с результатом, полученным на CPU.
dotProd.cu
#include #define imin(a,b) (a // set the cache values cache[cacheIndex] = temp; // synchronize threads in this block __syncthreads(); // for reductions, threadsPerBlock must be a power of 2 // because of the following code int i = blockDim.x/2; while (i != 0) < if (cacheIndex < i) cache[cacheIndex] += cache[cacheIndex + i]; __syncthreads(); i /= 2; >if (cacheIndex == 0) c[blockIdx.x] = cache[0]; > int main (void) < float *a, *b, c, *partial_c; float *dev_a, *dev_b, *dev_partial_c; // allocate memory on the cpu side a = (float*)malloc(N*sizeof(float)); b = (float*)malloc(N*sizeof(float)); partial_c = (float*)malloc(blocksPerGrid*sizeof(float)); // allocate the memory on the gpu cudaMalloc((void**)&dev_a, N*sizeof(float)); cudaMalloc((void**)&dev_b, N*sizeof(float)); cudaMalloc((void**)&dev_partial_c, blocksPerGrid*sizeof(float)); // fill in the host memory with data for(int i=0; i// copy the arrays 'a' and 'b' to the gpu cudaMemcpy(dev_a, a, N*sizeof(float), cudaMemcpyHostToDevice); cudaMemcpy(dev_b, b, N*sizeof(float), cudaMemcpyHostToDevice); dot>>(dev_a, dev_b, dev_partial_c); // copy the array 'c' back from the gpu to the cpu cudaMemcpy(partial_c,dev_partial_c, blocksPerGrid*sizeof(float), cudaMemcpyDeviceToHost); // finish up on the cpu side c = 0; for(int i=0; i #define sum_squares(x) (x*(x+1)*(2*x+1)/6) printf("GPU - %.6g \nCPU - %.6g\n", c, 2*sum_squares((float)(N-1))); // free memory on the gpu side cudaFree(dev_a); cudaFree(dev_b); cudaFree(dev_partial_c); // free memory on the cpu side free(a); free(b); free(partial_c); > Сборка и запуск:
/usr/local/cuda/bin/nvcc --cudart=shared dotProd.cu -o dotProd ./dotProdТакой результат говорит нам, что всё у нас хорошо:
GPU — 2.57236e+13
CPU — 2.57236e+13
Пример 3
Запустим еще один стандартный тест CUDA- matrixMulCUBLAS (перемножение матриц).
cd < YYY>/NVIDIA_CUDA-8.0_Samples/0_Simple/matrixMulCUBLAS make EXTRA_NVCCFLAGS=--cudart=shared ./matrixMulCUBLASРезультат
[Matrix Multiply CUBLAS] — Starting…
GPU Device 0: «GeForce GTX 660» with compute capability 3.0
MatrixA(640,480), MatrixB(480,320), MatrixC(640,320)
Computing result using CUBLAS. done.
Performance= 436.24 GFlop/s, Time= 0.451 msec, Size= 196608000 Ops
Computing result using host CPU. done.
Comparing CUBLAS Matrix Multiply with CPU results: PASS
NOTE: The CUDA Samples are not meant for performance measurements. Results may vary when GPU Boost is enabled.
Performance= 436.24 GFlop/s,
Comparing CUBLAS Matrix Multiply with CPU results: PASS
Безопасность
Я не нашёл в документации к rCUDA упоминания о каком-либо способе авторизации. Думаю, на данный момент самое простое, что можно сделать, это открыть доступ к нужному порту (8308) только с определённого адреса.
При помощи iptables это будет выглядеть так:
iptables -A INPUT -m state --state NEW -p tcp -s --dport 8308 -j ACCEPTВ остальном оставляю вопрос безопасности за рамками данного поста.
Запуск кода CUDA на видеокартах AMD
Многим известно, что CUDA является наиболее часто используемой платформой для ускорения массовых параллельных вычислений, применяемых в различных практических и исследовательских областях.
В 2016 году AMD представила в буквальном смысле клон платформы CUDA — ROCm. Альтернативы модулей CUDA для ROCm можно увидеть в таблице с официального сайта AMD.
Таблица соответствия модулей платформ
Модуль платформы CUDA
Модуль платформы ROCm
Данная библиотека позволяет в автоматическом режиме переносить исходный код предназначенный для платформы CUDA на ROCm и выполнять его компиляцию. Одним из недостатков данной платформы является исключительная ориентированность на ОС Linux.
Перейдем непосредственно к переносу кода и сравнению производительности платформ.
Тестовая конфигурация
Windows 10 Pro 21H1
x2 Intel Xeon Gold 6132
GeForce RTX 3070 8GB
Radeon RX 6800 XT 16GB
1. Установка CUDA на ОС Windows
Переходим на сайт NVidia (https://developer.nvidia.com/cuda-downloads) и скачиваем последнюю версию CUDA Toolkit для необходимой платформы. На скриншоте ниже представлена минимально необходимая конфигурация для компиляции и запуска платформы CUDA на ОС Windows.
Минимально необходимая конфигурация установки

2. Установка ROCm на ОС Linux
Рассмотрим ход установки ROCm на ОС Ubuntu 22.04. (https://docs.amd.com/bundle/ROCm-Installation-Guide-v5.3/page/How_to_Install_ROCm.html — на данном веб-сайте перечислены способы установки для некоторых других дистрибутивов Linux)
2.1 Загружаем пакет установщика и устанавливаем его.
sudo apt-get update wget https://repo.radeon.com/amdgpu-install/5.3/ubuntu/jammy/amdgpu-install_5.3.50300-1_all.deb sudo apt-get install ./amdgpu-install_5.3.50300-1_all.deb2.2 Установка необходимых компонентов ROCm
sudo amdgpu-install --usecase=dkms,rocm,rocmdevtools,lrt,hip,hiplibsdk,mllib,mlsdkВ процессе установки могут появиться ошибки, однако они никак не должны повлиять на работу платформы. На самом деле я на 100% не уверен, что это минимально необходимый набор модулей для установки, но путем проб и ошибок я пришел именно к этому набору.
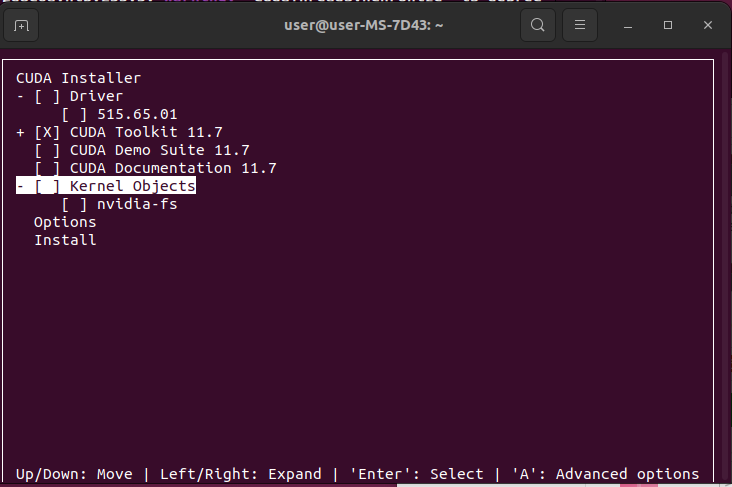
2.3 Установка CUDA.
Для портирования кода CUDA на ROCm также необходимо установить CUDA Toolkit. Проще всего это сделать следующей командой. (Другие версии CUDA и методы установки можно найти на данной веб-странице https://developer.nvidia.com/cuda-downloads)
wget https://developer.download.nvidia.com/compute/cuda/11.8.0/local_installers/cuda_11.8.0_520.61.05_linux.run sudo sh cuda_11.8.0_520.61.05_linux.runКонфигурация установки CUDA
3. Компиляция исходного кода на ОС Windows
В качестве тестового примера возьмем код перемножения матриц случайных целых 32-битных чисел с Github (https://github.com/lzhengchun/matrix-cuda).
С помощью команд PowerShell представленных ниже скачиваем и компилируем исходные файлы. После выполнения приведенных ниже команд в директории с исходным кодом появится исполняемый файл «a.exe».
git clone https://github.com/lzhengchun/matrix-cuda cd matrix-cuda nvcc ./matrix_cuda.cu4. Преобразование кода CUDA в код ROCm и его компиляция на ОС Ubuntu
Преобразование кода CUDA в ROCm выполняется при помощи утилиты платформы ROCm HIPIFY(от HIP — язык программирования платформы ROCm)
git clone https://github.com/lzhengchun/matrix-cuda cd matrix-cuda /opt/rocm-5.3.0/bin/hipify-clang matrix_cuda.cuПосле выполнения данных команд в директории рядом с файлом matrix_cuda.cu появится файл matrix_cuda.cu.hip, который является файлом исходного кода для платформы ROCm.
Компиляция кода для платформы ROCm выполняется при помощи компилятора HIPCC. После выполнения приведенных ниже команд в директории с исходным кодом появится исполняемый файл «a.out».
/opt/rocm-5.3.0/bin/hipсс matrix_cuda.cu.hip